Google Cloudは、AI学習のベンチマーク「MLPerf Training v6.1」で、第7世代のIronwood TPUとNVIDIA製GPUを使った10件の結果を公開しました。Ironwood TPUを8,192個使った事前学習では、対象モデルが目標品質に達するまでに1.70分かかりました。自律的に行動するAIの強化学習を対象としたMLPerf初のベンチマークも含まれます。
Ironwoodの事前学習で1.70分を記録
事前学習は、モデルを一から学習させる工程です。Ironwood TPUを使った測定では、8,192個のTPUで対象モデルを学習し、目標とする品質に1.70分で到達しました。
Google Cloudは、4,096チップまで規模を拡大した際の効率を96%としています。事前学習の結果は、MLPerf Training v6.1に提出した10件のうちの1つです。測定にはGoogle CloudのAI Hypercomputerアーキテクチャーが使われました。
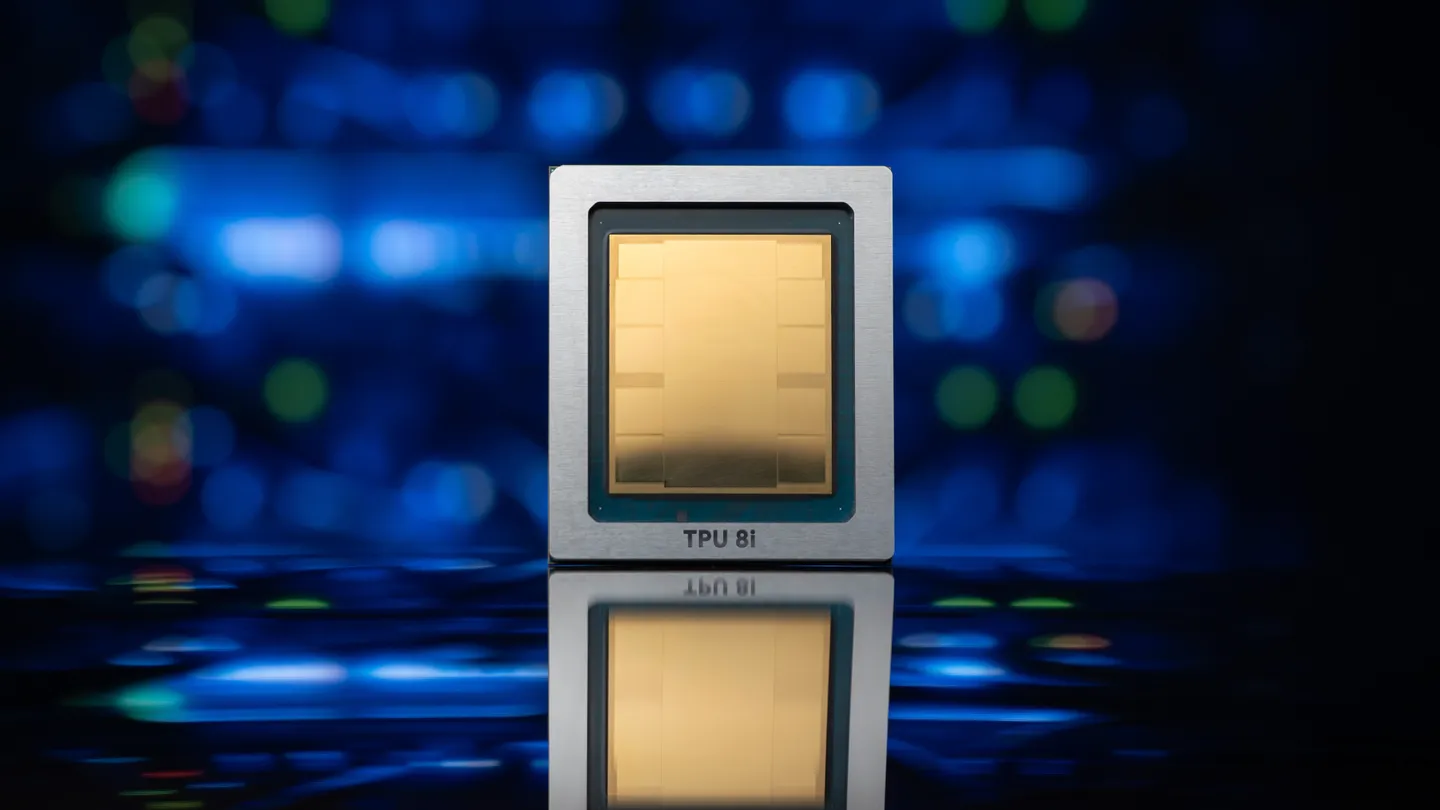
TPUは、GoogleがAIや機械学習向けに開発した専用チップです。Ironwoodはその第7世代に当たり、大規模なAIの学習と推論向けに設計されています。
コード生成と学習を同時に進めた強化学習
今回のMLPerfには、エージェント型の強化学習を対象とする初のベンチマークが含まれます。強化学習は、行動の結果を基にモデルを学習させる方法です。Ironwoodでは640個のTPUを使い、コーディングの目標精度に18.02分で到達しました。
この測定で得られた精度は0.765でした。目標値は0.69です。コード生成と学習は同時に実行されました。
Google Cloudは、この実行中に学習用チップが待機した時間は3%未満だったとしています。同社はIronwoodの結果に加え、GPUを使ったエージェント型強化学習の結果も提出しました。GPUによる提出はA4XとA4X Maxのインスタンスを合わせて5件です。
NVIDIA製GPUでも学習結果を提出
Google CloudのA4X Maxインスタンスを使った別の測定では、NVIDIA GB300 GPUを256個使用しました。対象モデルがベンチマークの目標品質に達するまでの時間は31.96分でした。この結果もMLPerf Training v6.1に提出された10件に含まれます。
実行基盤には、チップ、ネットワーク、オープンなソフトウェアを組み合わせたAI Hypercomputerが使われました。
Ironwoodはチップを2つの構成要素に分割
Ironwood世代の最初の製品であるTPU7xは、1チップに2つのTensorCoreと4つのSparseCoreを搭載します。TensorCoreは大規模な行列演算を担い、SparseCoreは疎な演算を使うモデルを高速化する処理部です。前世代のTrilliumに当たるTPU v6eは、1チップ当たりTensorCoreが1つ、SparseCoreが2つでした。
Ironwoodのチップは、それぞれ専用のメモリー領域を持つ2つのチップレットで構成されます。各チップレットにはTensorCoreが1つ、SparseCoreが2つ、高帯域幅メモリーが96GiB搭載されています。1チップ当たりのメモリー容量は192GiBで、Trilliumの32GiBから増えています。
2つのチップレットは、ダイ間接続と呼ばれる高速な接続で結ばれています。JAXなどの機械学習フレームワークは、Ironwoodの1チップを2つのデバイスとして扱います。TPU7xではJAXとPyTorchを利用できます。
最大9,216チップを接続する構成
TPUを専用ネットワークでまとめた単位はPodと呼ばれます。TPU7xのPodは最大9,216チップで構成されます。TrilliumのTPU v6eでは1 Pod当たり256チップです。
TPU7xのチップは、隣接するチップと3次元に接続されています。64チップ以上の構成では、4×4×4のチップ群を1つ以上組み合わせます。これらは3次元トーラスと呼ばれる形で相互接続されます。
チップ間接続の双方向帯域幅は、TPU7xでは1チップ当たり合計1,200GB/秒です。TrilliumのTPU v6eは800GB/秒でした。TPU7xのチップには、それぞれ200GB/秒の双方向帯域幅を持つ接続が6本あります。