Microsoft Researchは、AIコーディングエージェントの過去の作業を活用し、トークン費用を抑えるオープンソースのプラグイン「TokenEconomizer」を紹介しました。6つのリポジトリにある277件のバグ修正タスクでは、エージェントとモデルの5通りの組み合わせで、1タスク当たりの平均コストが18.4〜30.9%低下しました。エージェント本体やAIモデルを変更せず、蓄積した知識を次の作業へ引き継ぎます。
繰り返しの調査や失敗による消費を抑える
AIコーディングエージェントは、モデルを呼び出すたびに指示やツールの説明、会話履歴を送ります。入出力の単位となるトークンの消費は、こうした情報量に応じて増えます。同じリポジトリでテスト方法を調べ直したり、使わないツールの説明を送り続けたりすることも費用につながります。
研究チームはClaude Codeを使い、実際のバグ修正を題材とするベンチマーク「SWE-Bench」の60タスクを分析しました。5件以上のタスクを終えたリポジトリでは、ツール呼び出しの30%が同じリポジトリの過去の作業と重複していました。別のリポジトリの履歴と一致した呼び出しは7%でした。
分析では、毎回渡される23種類のツール説明のうち、16種類のツールが一度も呼び出されませんでした。また、失敗したタスクは全体の17%でしたが、費用の32%を占めました。コマンド出力の短縮など、固定的な3つの費用削減手法を試したところ、リポジトリによって費用が減る場合と増える場合がありました。
作業履歴から知識とツールの使い方を学ぶ
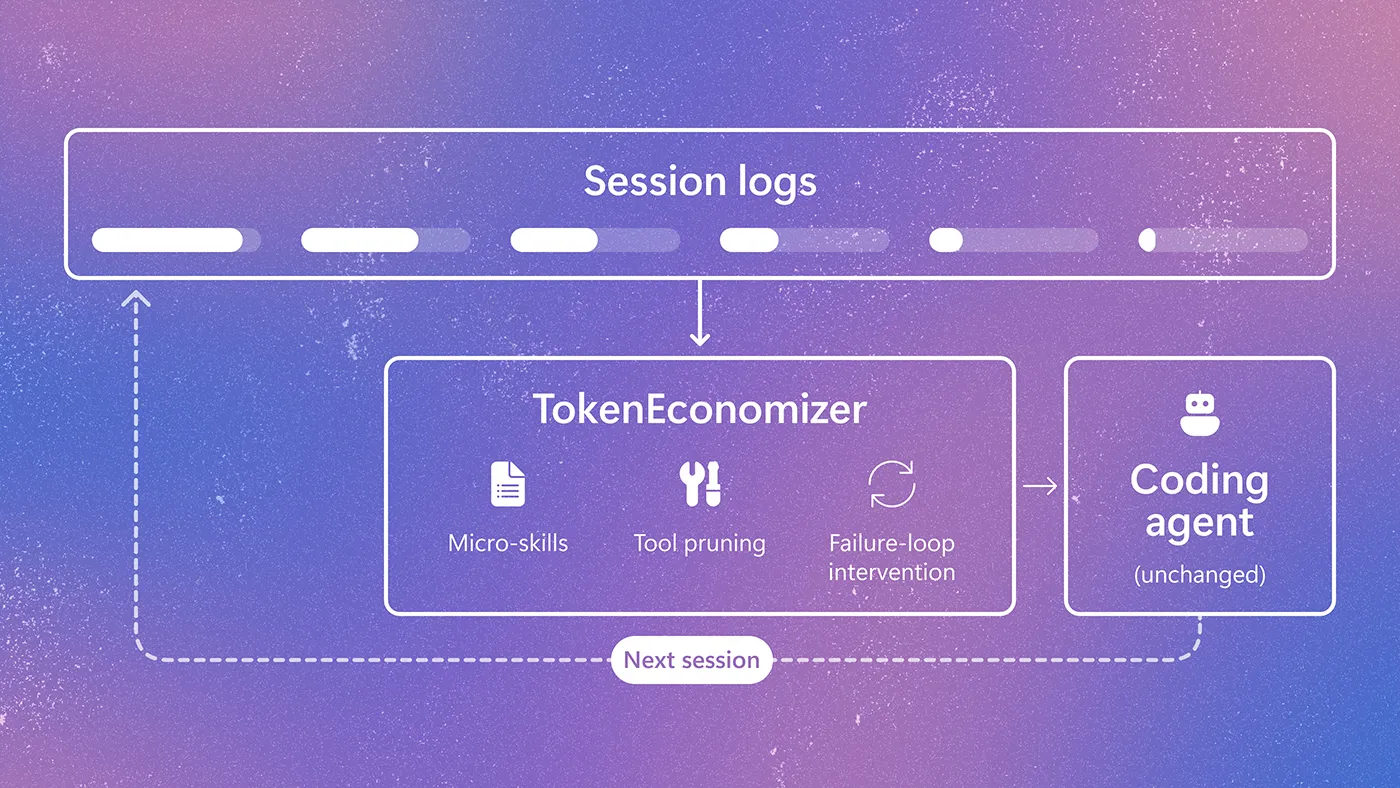
TokenEconomizerは、カリフォルニア大学バークレー校、Microsoft Research、Microsoft Securityの研究チームが開発しました。終了したセッションの記録を基に、リポジトリごとに次の作業で使う知識やツールを選びます。学習した情報は利用者のマシンに保存されます。
「Micro-skills」は、テストコマンドやビルド前の準備といったリポジトリ固有の知識を短い指示にまとめる仕組みです。複数のセッションで確かめられた内容を、次のセッションの開始時にエージェントへ渡します。後の作業で矛盾する結果が出た指示は取り下げます。
「Tool pruning」は、複数のセッションにわたり使われなかったツールを、エージェントの設定から読み込み対象外にします。これにより、モデルへ送るツールの説明を減らします。コマンド実行やファイルの読み書き・編集に使う基本ツールは残り、対象外にしたツールも利用者が戻せます。
行き詰まりを判定し別の方法を促す
「Loop intervention」は、同じ失敗を繰り返す作業に介入する仕組みです。判定用のモデルが作業の進捗を調べ、行き詰まっていると判断すると、別の方法を試すよう短い指示を渡します。指示後も行き詰まりが続く場合は利用者に通知します。
配布版では、通知を受けた後に作業を止めるかどうかは利用者が決めます。一方、バグ修正タスクの評価には、指示後も行き詰まっていると判定した作業を自動停止する研究用の構成が使われました。3つの仕組みは設定で個別に有効・無効を切り替えられます。
学習対象には、コマンドの実行方法や必要な環境変数、生成ファイルの置き場所などが含まれます。学習した情報は利用者のマシン上の「~/.tokeneconomizer」に保存されます。知識の候補を作る処理や行き詰まりの判定に使うモデルの呼び出しは、利用者自身のエージェントを通じて、同じ契約またはログインで実行されます。
277件のバグ修正で平均コストを比較
評価では、各リポジトリについてTokenEconomizerに履歴がない状態から始め、タスクを時系列順に実行しました。セッションはタスクごとに分け、学習した情報を次のタスクへ引き継ぎました。同じ277タスクを、プラグインを使わない場合とも比較しました。
エージェントとモデルの組み合わせは、Claude Codeで2種類、Codexで2種類、GitHub Copilot CLIで1種類の計5通りです。すべてのリポジトリと組み合わせで、未導入時よりコストが低くなりました。費用の計算にはキャッシュ利用時の料金と、TokenEconomizer自身のモデル呼び出し費用も含まれます。
初回の試行でタスクを解決できた割合は、5通りのうち4通りで向上し、残る1通りでは1.0ポイント低下しました。比較のためモデルの推論量を下げた実験では、費用とともに解決率も低下しました。履歴が少ない初期には費用が増える場合もありましたが、Claude Codeと2種類のモデルを使った比較では、その結果を平均すると、すべてのリポジトリで6件目までに累計コストが未導入時を下回りました。
Web開発とセキュリティ監査でも評価
研究チームは、同じプロジェクトでタスクを順に実行するWeb開発のベンチマーク「Web-Bench」でも評価しました。この実験では、コストが16.0〜21.2%低下しました。
セキュリティ監査の評価では、タスクごとに異なるリポジトリを共通の監査手順で調べました。同じリポジトリの次のタスクへ知識を引き継ぐ機会がないため、Micro-skillsは無効にしました。残る2つの仕組みを使った結果、コストは6.4〜19.6%低下しました。
配布版はClaude Code、Codex、GitHub Copilot CLI、Piにプラグインとして追加して使います。利用には、Python 3.10以降をコマンドラインから実行できる環境が必要です。プラグイン自体のAPIキーは不要で、対応するエージェントにログインして利用します。