TopicBase
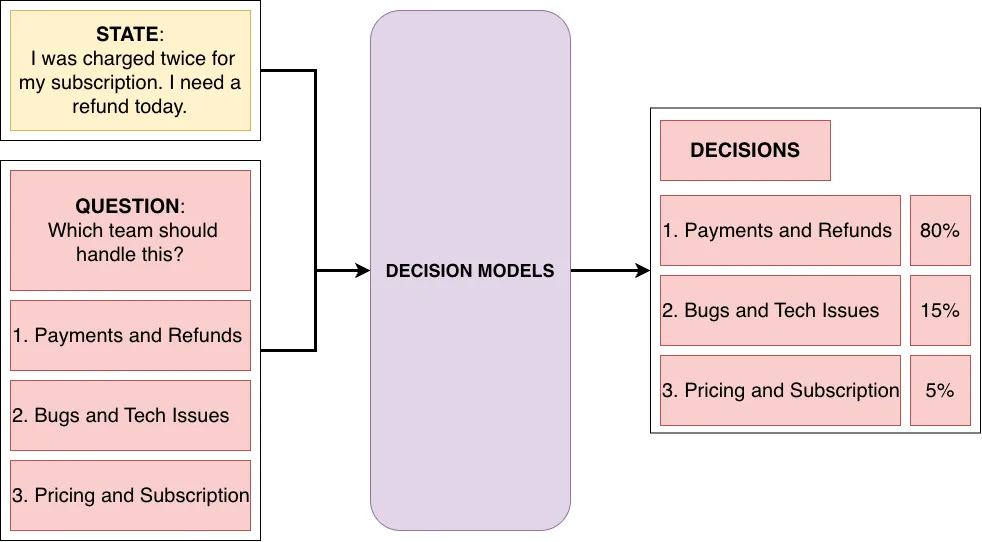
Hugging Faceの機械学習ライブラリTransformersでは、文章を生成する代わりに、あらかじめ用意した選択肢を評価して判断と確率を返す「決定モデル」を利用できます。同じ入力に対して担当部署、緊急度、返金要求の有無などをまとめて問い、ソフトウェアが扱える構造化された値を受け取る仕組みです。モデルを追加学習するUnslothの手順が公開され、Hugging Faceの学習ライブラリTRLでも実験的な学習機能の追加が提案されています。
入力と質問を分け、3種類の形式で判断する
決定モデルの基本構成は、判断対象の入力情報「state」と、質問や許容する回答を定義する「questions」です。stateには文章や構造化されたJSONオブジェクトを渡せます。例えば顧客からの問い合わせに、契約プランや過去の問い合わせ件数を組み合わせて評価できます。
回答形式には、選択肢から1つを選ぶ「choice」、順序のある尺度で評価する「score」、はい・いいえの問いを確率的に扱う「noul」があります。choiceは各候補の確率を計算して最も確率の高いものを選び、scoreは各段階の確率から段階番号の期待値を求める仕組みです。問い合わせの処理なら、部署の選択、緊急度の採点、返金要求の判定を、それぞれ異なる回答形式で指定できます。
Transformersでは、pipeline("decision")にモデルを指定し、stateとquestionsを渡して実行します。autotrust/GEV-26B-Decideを使う例では、支払い、技術、営業の担当範囲を候補ごとに記述し、選ばれた部署に加えて各候補の確率と信頼度を受け取ります。
固定ラベルの分類と、文章による回答生成との違い
従来の分類モデルは、学習時に定めたラベルに対応する出力部分を持ちます。部署を増やす場合などには、その出力部分の変更や追加学習が必要になることがあります。一方、実行時に候補を渡すゼロショット分類は、問い合わせごとに候補を変更できる仕組みです。
決定モデルも実行時に選択肢を指定しますが、同じ入力に複数の名前付き質問を設定し、選択、順序付きの採点、二択を共通のインターフェースで扱います。候補ごとの確率分布も返します。
TypeSafe AIは、この方式に関わるモデル「Jev」を早期アクセスで提供しています。同社は、文字列を生成せず、型の決まった判断を確率付きで返すために、独自のモデル構造、並列サンプリング、確率の校正を重視する強化学習手法「RLCD」を採用したとしています。
大規模言語モデル(LLM)からJSONなどを得る別の方法が、出力可能なトークンを各段階で制限する「制約付き生成」です。トークンは文章を処理・生成する際の単位で、XGrammarは生成済みの内容と文法上の状態を使い、次に出せるトークンを絞り込みます。
制約付き生成は文章を順に生成する処理を続けますが、決定モデルは用意された回答候補を直接評価します。XGrammarは制約の確認処理を軽くするため、多くのトークンの適否を事前計算して保存し、実行時には残る部分を確認する仕組みです。さらに文法の計算とGPUの処理を重ね合わせる最適化も取り入れています。
Unslothでの追加学習と、TRLへの実験的な導入
Unslothでは、QwenやGemmaなどのLLMを追加学習し、入力と選択肢から判断と確率を返すモデルにできます。学習データは入力のstate、質問のquestions、正解のgoldで構成し、1件に複数の質問を含められます。正解に使う値は、choiceでは候補のキー、noulでは真偽値、scoreでは0から始まる段階番号です。
推論時は入力と全質問を1つのプロンプトにまとめ、LLMが読み取った結果を小さな判定用の出力部分で評価します。学習したモデルはDecision APIを通じて呼び出せるほか、コードから判断や評価を実行する機能も用意されています。
TRLには、Transformersのモデルと損失関数を利用する実験的な「DecisionTrainer」の追加がドラフトの変更提案として登録されています。提案にはBANKING77データセットを用いた学習例と文書が含まれ、作成者は24件のテスト、5種類の分散実行構成、AMD ROCm環境での学習を検証したとしています。
判断に添える確率を、実際の正答率と照らす
決定モデルが返す確率に関わる概念が「校正」です。校正とは、予測に付く確率と実際の正答率の対応を指し、信頼度80%の予測を集めたとき、その約80%が正しい状態が例になります。TypeSafe AIはJevについて、判断ごとに校正された確率と信頼度を返すとしています。
校正の検証には、予測を信頼度の区間ごとに分け、各区間の平均信頼度と正答率を比較する「信頼度図」が使われます。また、その差を集約する指標が「期待校正誤差(ECE)」です。問い合わせの自動振り分けで確率を判断材料にする場合にも、この比較で出力確率と実際の正解との対応を評価できます。
校正を補正する方法の1つが、モデルの出力スコアを単一のパラメーターで調整する「温度スケーリング」です。コーネル大学のGuo氏らは、画像と文書の分類を対象に複数の補正方法を比較し、多くのデータセットでこの方法が有効だったと報告しています。Cheng Wang氏による研究レビューでは、校正手法を学習後の補正、正則化、不確実性の推定、複数手法の組み合わせに分類しています。