TopicBase
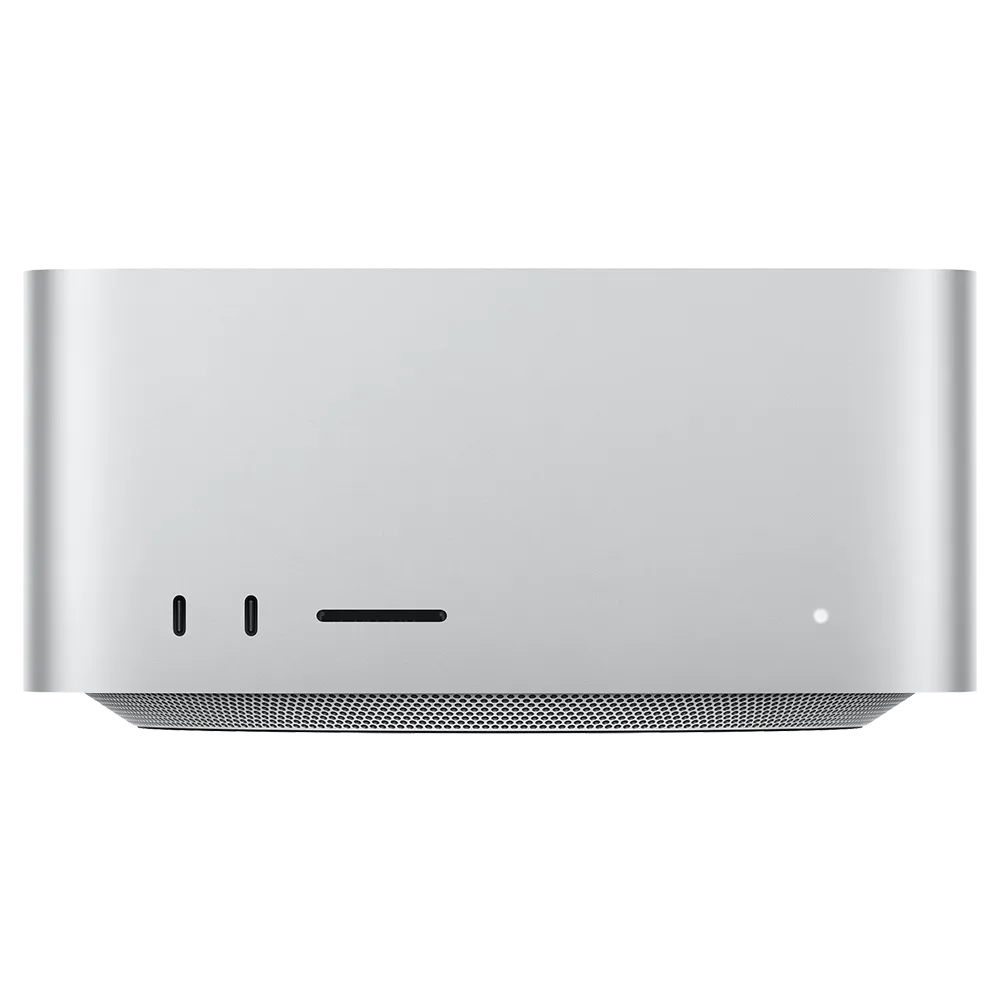
M5 Ultra搭載Mac Studioは、ローカルでAIを動かす比較テストで、DGX Spark相当のシステム1台に対し、処理時間を半分未満に短縮し、処理全体の消費エネルギーも約16%削減しました。一方、大規模なモデルではDGX Spark相当の2台構成が速い場合もあり、モデルを実行する推論エンジンや設定の組み合わせで結果が大きく変わりました。
Qwenのテストでは処理時間と消費エネルギーを削減
テストに使われたMac Studioは、36コアCPUと80コアGPUを備えるM5 Ultra、256GBのメモリーを搭載した構成です。比較相手には、NVIDIAのDGX Sparkとほぼ同じ構成のDell Pro Precision GB10が使われました。
「AgentPerf-Local」は、記録済みの処理を再現し、AIが複数の作業を進める際の推論処理を測るテストです。文章の生成よりも、入力されたプロンプトの処理が作業の大部分を占めます。
両システムでは言語モデル「Qwen 3.8 27B」を推論エンジン「llama.cpp」で動かし、複数トークンを予測して生成を速めるMTPも有効にしました。Mac Studioは同じ作業を半分未満の時間で終え、消費エネルギーも約16%少なくなりました。処理時間と消費エネルギーを掛け合わせ、速度とエネルギー効率を併せて表す指標「EDP」も、比較相手の半分未満でした。
大規模モデルでは256GBの容量と2台接続を比較
より大きなモデルとして、「DeepSeek V4.1 Flash 1017」と「GLM 5.3 Flash」も試されています。数値の表現に使うビット数を減らしてメモリー使用量を抑える量子化を適用し、DeepSeekは2ビット、GLMは4ビットのモデルをMac Studioの256GBメモリーに収めました。
これらの量子化モデルは128GBのDGX Spark単体には収まらないため、比較にはDell製システム2台を接続した構成が使われました。検証したMac Studioの価格は1万2300ドル(約190万円)以上で、Dell製システム2台の構成は2万ドル(約320万円)でした。
DeepSeekでは、Mac Studio側はllama.cppを使用しました。生成を高速化する投機的デコード用の追加モデル「DSpark」は、本体のモデルと同時にメモリーへ収められず、使われていません。対する2台構成では、Mia’s AI Labによる実行設定を使い、推論エンジン「TensorFold」とDSparkを組み合わせました。
テストした長い入力の処理には、Mac Studioで10〜25分かかったのに対し、2台構成では最長でも5分未満でした。生成速度も2台構成のTensorFoldが上回りました。
GLMはMac Studio側のエンジン変更で生成速度が平均3倍
GLM 5.3 FlashのMTPは別の予測用モデルを必要とせず、Mac Studioでも生成の高速化を有効にできました。llama.cppで動かした場合、Mac Studioは生成速度で2台構成を上回りましたが、入力処理では2台構成の方が速い結果でした。
Mac Studio側をTensorFoldとApple Silicon向けのMLX専用4ビット量子化モデルの組み合わせに替えると、入力処理時間は2台構成に近づきました。生成速度は、同じMac Studioでllama.cppを使った場合の平均3倍になりました。
入力処理と生成で結果が異なる背景には、処理の性質の違いがあります。大規模言語モデルの入力処理は入力全体を並列に扱うため計算能力が制約になりやすく、生成はトークンごとにモデルの重みを読み込むためメモリー帯域が制約になりやすい処理です。この違いから、今回の比較では入力処理時間と生成速度を分けて測っています。
入力長も処理量に影響します。通常の自己注意機構では、入力処理の計算量は系列長の二乗に比例して増加します。ウプサラ大学の研究チームによるシミュレーションでは、演算周波数を高めると入力処理の待ち時間は短くなる一方、生成の高速化は外部メモリー帯域によって頭打ちになりました。
Apple Siliconでもモデルごとに最適化の効果が異なる
Contra CollectiveはM5 Max搭載MacBook Proで、別のモデル「Llama 3.3 70B Instruct」をmlx-lmとllama.cppのMetalバックエンドで比較しています。MetalはAppleのGPUを利用するための仕組みで、MLXはApple Silicon向けの機械学習フレームワークです。
Contra Collectiveの測定では、入力が1万6000トークンの単一リクエストで、llama.cppの入力処理時間は16.8秒、mlx-lmは22.1秒でした。一方、入力と出力が各1000トークンの8件同時処理では、全体の生成速度はmlx-lmが毎秒52.1トークン、llama.cppが毎秒44.6トークンでした。
GPU上で時間がかかる処理も、モデルによって異なります。AtomGradientによるM2 UltraとMLXを使った査読前研究では、Qwen3.5-9Bの512トークン入力処理で、線形変換の量子化行列積が処理時間の57.6%、通常の注意機構が6.7%を占めました。同研究で試した、入力内の語の並びを再利用する投機的デコードは、Qwen3-8BとQwen3.5-9Bのいずれでも高速化につながりませんでした。
2ビット・4ビット化の精度は方式や規模でも変化
今回の大規模モデルをメモリーに収めた量子化は、回答精度にも関わります。Jemin Lee氏らの研究では、70B規模のモデルは4ビット化後も比較的安定した性能を保つ一方、小規模モデルでは精度が大きく低下する場合がありました。また、重みを量子化する方式ではAWQがGPTQを上回る傾向があり、影響はモデルの規模や課題によって異なりました。
Renren Jin氏らの研究でも、評価対象のモデルは4ビット化後に非量子化モデルと同程度の性能を保つ場合がありました。2ビット化では、外れ値となる重みを分離して扱うSpQRが、同じビット数のGPTQを大きく上回りました。同研究は、量子化でメモリー使用量を減らしても推論が遅くなる場合があり、生成速度とメモリー消費の削減を両立するには実装とハードウェアの対応が必要だとしています。