TopicBase
検索向けの機械学習ライブラリ「Sentence Transformers」で、文書を表すベクトルの圧縮を学習に組み込む「プーリング対応学習」の実装例が公開されました。文書ベクトルを約4分の1に減らす評価では、圧縮前に対する検索スコアの保持率が、通常学習の94.6%から97.8%に上がりました。
ベクトル数を減らす際の情報損失を学習で抑える
ColBERTなどのマルチベクトル検索モデルは、文章の処理単位であるトークンごとに、文脈を反映した数値列「ベクトル」を保持します。検索時には、検索語側の各ベクトルに最もよく合う文書側のベクトルを探し、その類似度を足し合わせる「MaxSim」で関連度を計算します。
この方式では、検索語の異なる部分を文書内の別々の箇所と照合できますが、保存するベクトル数が多くなります。そこで使うのが、似たトークンのベクトルをまとめ、平均値で置き換える「トークンプーリング」です。
通常学習では、圧縮前の表現で検索するようにモデルを調整します。今回の実装例では、圧縮前と、文書ベクトルを約4分の1にした圧縮後の両方で検索誤差を計算し、それぞれを半分ずつの重みで学習に反映します。これにより、ベクトルの統合後も検索に必要な情報が残るよう、同じモデルを調整する仕組みです。
13データセットで圧縮後のスコアを比較
評価には、検索性能を測るNanoBEIRの全13データセットを使っています。通常学習とプーリング対応学習のモデルは、同じ12万件のMS MARCOの学習例を使い、初期化や最適化の条件をそろえ、学習時の誤差の計算方法だけを変更しました。
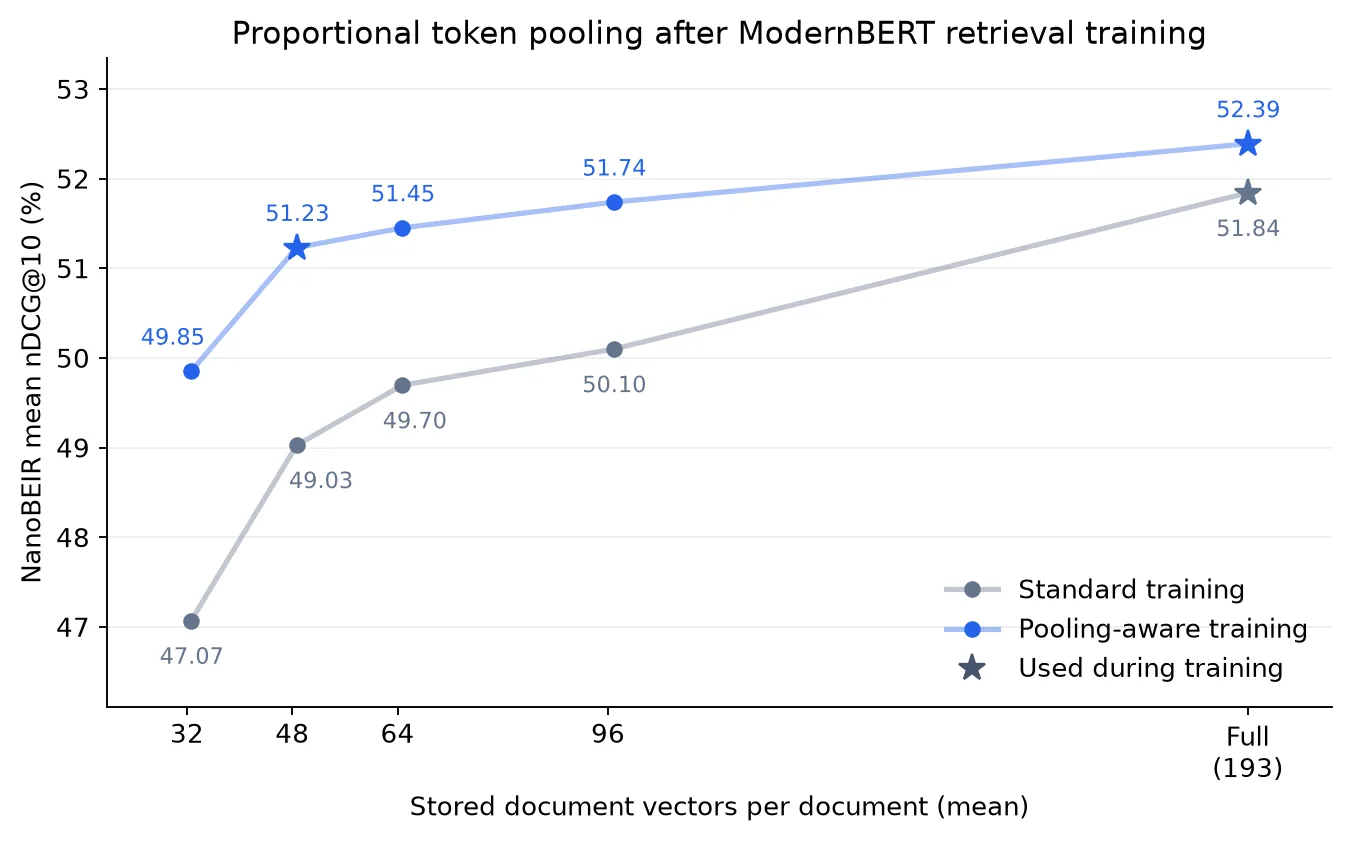
指標は、検索結果の上位10件の関連度と並び順を評価する「nDCG@10」の平均です。文書ベクトルを約4分の1にする設定では、通常学習の49.03に対し、プーリング対応学習は51.23となり、2.20ポイント上回りました。圧縮前のスコアはそれぞれ51.84と52.39で、各モデルの圧縮前を基準にした保持率が94.6%と97.8%です。
学習で使った圧縮率以外でも差が出ています。文書当たり最大4ベクトルに制限した場合、スコアは通常学習の37.22に対し、プーリング対応学習では43.00でした。また、内容に応じてベクトル数を変える設定では、平均29.58ベクトルで圧縮前のスコアの97.3%を保持し、ベクトル数を84.7%削減しました。
圧縮量は上限・比率・類似度で指定
実装に使う「HierarchicalTokenPooling」は、似たベクトルを段階的に統合する階層クラスタリングを採用しています。統合によるグループ内のベクトルのばらつきの増加が最も小さい組み合わせを選ぶWard法を使い、各グループの平均を正規化して出力します。
圧縮量の指定方法は3種類あります。「max_tokens」は文書ごとのベクトル数の上限、「pool_factor」は元のベクトル数に対する圧縮比率、「distance_threshold」は統合を進める距離のしきい値です。既定では先頭トークンを統合から保護し、検索語側のベクトルは圧縮しません。
距離のしきい値を使う方式では、代表的な文書群で、目標とする平均ベクトル数に合うしきい値を調整できます。例えば平均16ベクトルを目指す場合も、個々の文書には16より多い、または少ないベクトルを割り当てられます。別の文書群に適用した場合、実際の平均値は変わることがあります。
既存の検索用学習処理に圧縮の目標を追加
学習用の「MultiVectorTokenPoolingLoss」は、既存のマルチベクトル検索用の誤差計算をラップし、指定した圧縮設定ごとに適用します。圧縮前と圧縮後の処理でモデルが生成したベクトルを再利用するため、圧縮設定を追加しても、設定ごとに文章をベクトル化し直す必要はありません。
公開された学習スクリプトは、文章をベクトル化するモデル「ModernBERT-base」を出発点に、1回の学習バッチを256例、内部処理の小分けを64例として学習します。「--baseline」を指定すると通常学習に切り替わり、同じ条件で比較できます。学習後はモデルを保存し、圧縮した文書ベクトルで検索スコアを計算する処理も含まれています。
先行研究「Learn to Pool」でも、既存のColBERTモデルを小規模に追加学習し、圧縮を推論時だけに適用する場合より検索性能を改善する手法が検証されています。研究者のStefan Josef氏は、改善幅は圧縮率やデータセットによって変わるものの、ある統合方式での学習が別の方式にも効果を及ぼす結果を報告しています。
次元削減や量子化と組み合わせる圧縮
トークンプーリングが減らすのは、文書ごとに保存するベクトルの本数です。一方、ベクトルの先頭部分だけでも検索に使えるよう学習する「Matryoshka」は、各ベクトルの次元数を減らします。今回のプーリングでは、文章をベクトル化するモデル本体は通常どおり動き、保存とスコア計算の対象となる文書ベクトルを減らします。
各座標を表すビット数を減らす量子化も、プーリングと組み合わせられます。Fast-PLAIDが対応する4ビットの残差量子化を使う例では、128次元のベクトルを文書当たり200本保存する場合、100万文書の量子化済み残差は12.8GBです。同じ次元数と精度のまま50本に減らすと、3.2GBになります。
先行するトークンプーリングの検証でも、統合したベクトルをColBERTv2方式で2ビットに量子化して評価しています。
圧縮処理そのものには、ベクトルをグループ化する計算が加わります。数値計算ライブラリSciPyのWard法実装では、入力数をnとすると計算時間とメモリ使用量はいずれもO(n²)で増加します。Sentence Transformersの実装例では、対応するハードウェアでMaxSimやWard法を高速化する追加の計算処理を利用でき、互換性のあるパッケージが入っていれば学習・評価スクリプトが自動で有効にする仕組みです。