Thinking Machines、594Bパラメーターの「Inkling 2 Small」を発表

Thinking Machinesは2026年11月5日、AIモデル「Inkling 2 Small」を発表しました。利用者は同日から、同社のモデル訓練サービス「Tinker」で推論とファインチューニング(用途に合わせた追加学習)を利用できます。 モデルの全重みは、外部の安全性テストとレッドチームテストを終えた後、Apache 2.0ライセンスで翌週に公開する予定です。
好奇心が、日常をおもしろくする
Thinking Machinesは2026年11月5日、AIモデル「Inkling 2 Small」を発表しました。利用者は同日から、同社のモデル訓練サービス「Tinker」で推論とファインチューニング(用途に合わせた追加学習)を利用できます。 モデルの全重みは、外部の安全性テストとレッドチームテストを終えた後、Apache 2.0ライセンスで翌週に公開する予定です。

LemonadeがローカルAIサーバーのバージョン2026.45.3を公開し、デスクトップアプリとWeb UIを刷新しました。モデル管理やルーティング設定の画面を新設し、K2-HorizonファミリーとFlintモデルに対応しています。
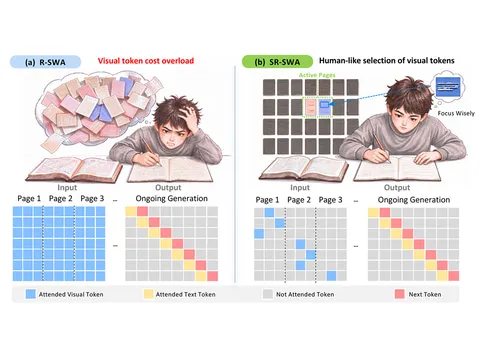
Baiduは10月27日、長文ドキュメント解析向けAIモデル「Unlimited OCR 2」をオープンウェイトで公開しました。OCR(画像中の文字を読み取る技術)を基盤とし、数百ページの文書を解析する際、文書が長くなるほど増える処理時間やメモリ使用量を抑える仕組みを備えています。
Mistralは、1兆パラメーターのAIモデル「Mistral Large 4(ML4)」の重みを公開しました。企業や政府機関はモデルをダウンロードし、自社環境で運用できます。サイバーセキュリティ向けの利用を掲げていますが、重みの公開に学習データや学習手順の公開が含まれるとは限りません。
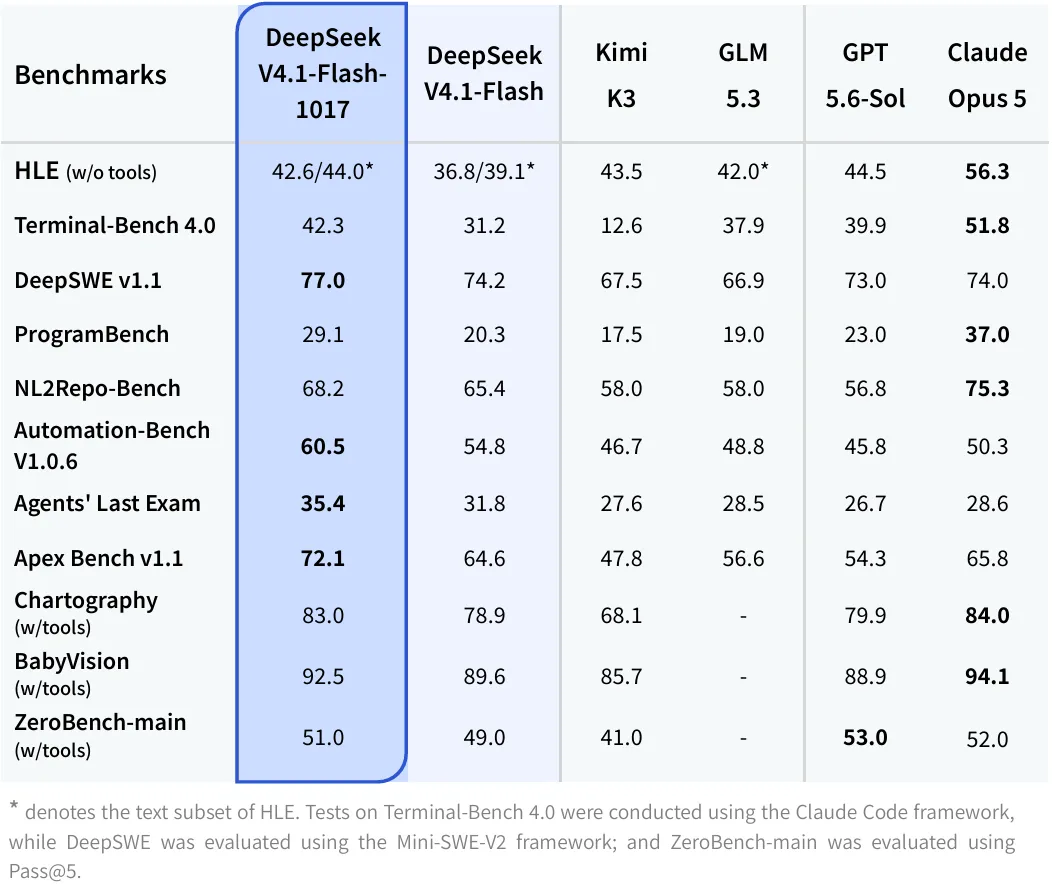
DeepSeekは、オープンウェイトモデル「V4.1 Flash」の改訂版「1017」を公開しました。前世代より推論時に使うKVキャッシュの容量を抑え、API料金も低く設定しています。一方、Artificial Analysisの評価では、根拠が不十分な質問に誤答する割合が高く、用途の選び方が重要です。
Cloudflareは2026年10月19日、非構造化データから数値や日付などを取り出すモデル「Clairic」のプレビューを発表しました。入力から値を抽出するだけでなく、計算や予測にも対応し、Workers AIで利用できます。
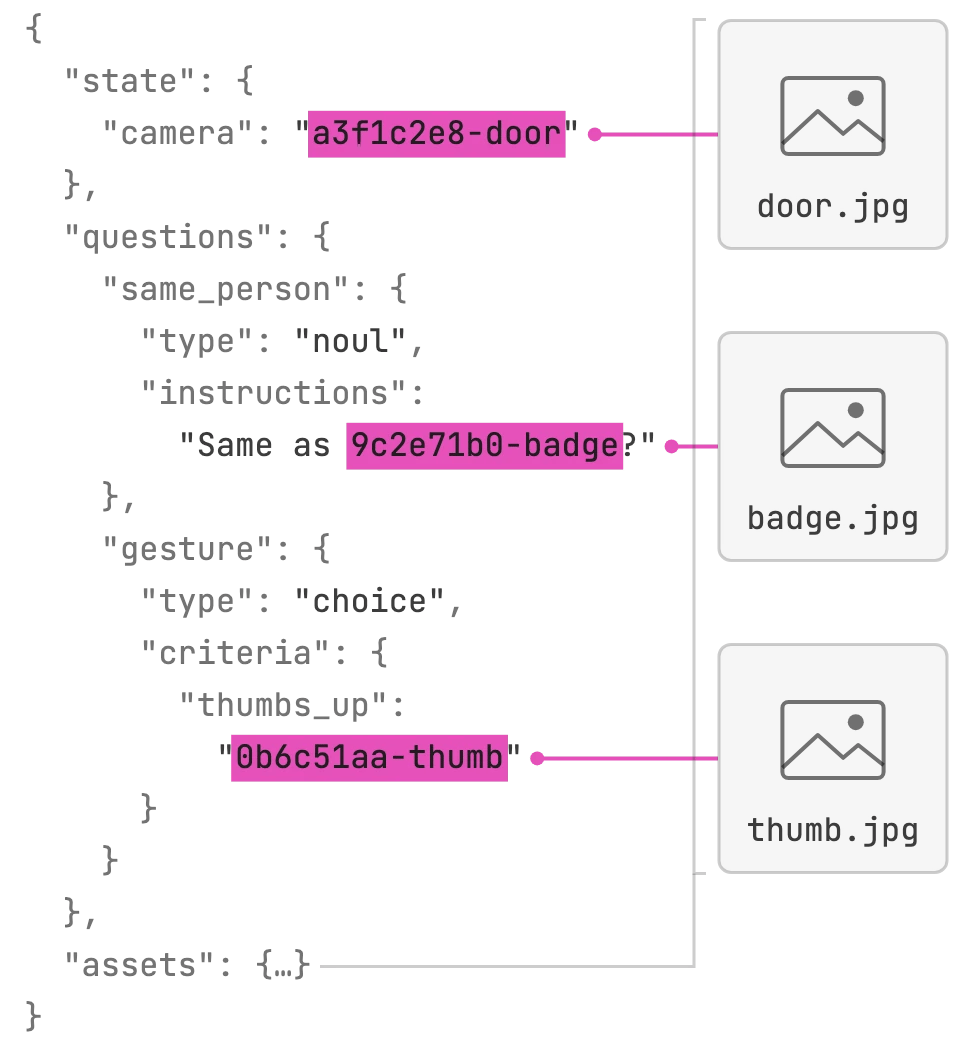
TypeSafe AIは10月14日、AIモデル「Jev」のバージョン1.14を公開しました。画像入力、画像内の対象を囲む座標の取得、最大262kトークンの入力に対応する実験機能を追加し、多言語対応も改善したとしています。画像入力と長いコンテキストは旧版のJev 1.13でも使えますが、いずれも本番利用向けではありません。
Cloudflareは、音声と動画をテキスト、画像とともに入力できるオープンウェイトモデル「Clef-omni」を公開しました。従来のClefに音声・動画を加え、複数の入力形式を一つのモデルで扱えるようにしました。あわせて、Clefの処理速度を上げ、Clef-flashの価格を引き下げました。
Mistralは10月6日、AIモデル「Mistral Large 4」のパブリックプレビューを公開しました。Artificial Analysisの総合指標では38点を記録し、米中以外のモデルで最高点となりました。一方、中国の複数のオープンウェイトモデルはLarge 4を上回っています。モデルの重みは10月末までに公開する予定で、現在はプレビューAPIで提供されています。
Anthropicは、AIモデル「Claude Haiku 5.5」を公開しました。Haiku 4.5と比べ、実行コストは平均約75%低いとしています。主な用途として、高頻度で費用を抑えたい処理を挙げています。