TypeSafe AIは10月14日、AIモデル「Jev」のバージョン1.14を公開しました。画像入力、画像内の対象を囲む座標の取得、最大262kトークンの入力に対応する実験機能を追加し、多言語対応も改善したとしています。画像入力と長いコンテキストは旧版のJev 1.13でも使えますが、いずれも本番利用向けではありません。
Jev 1.14で追加された画像の扱い
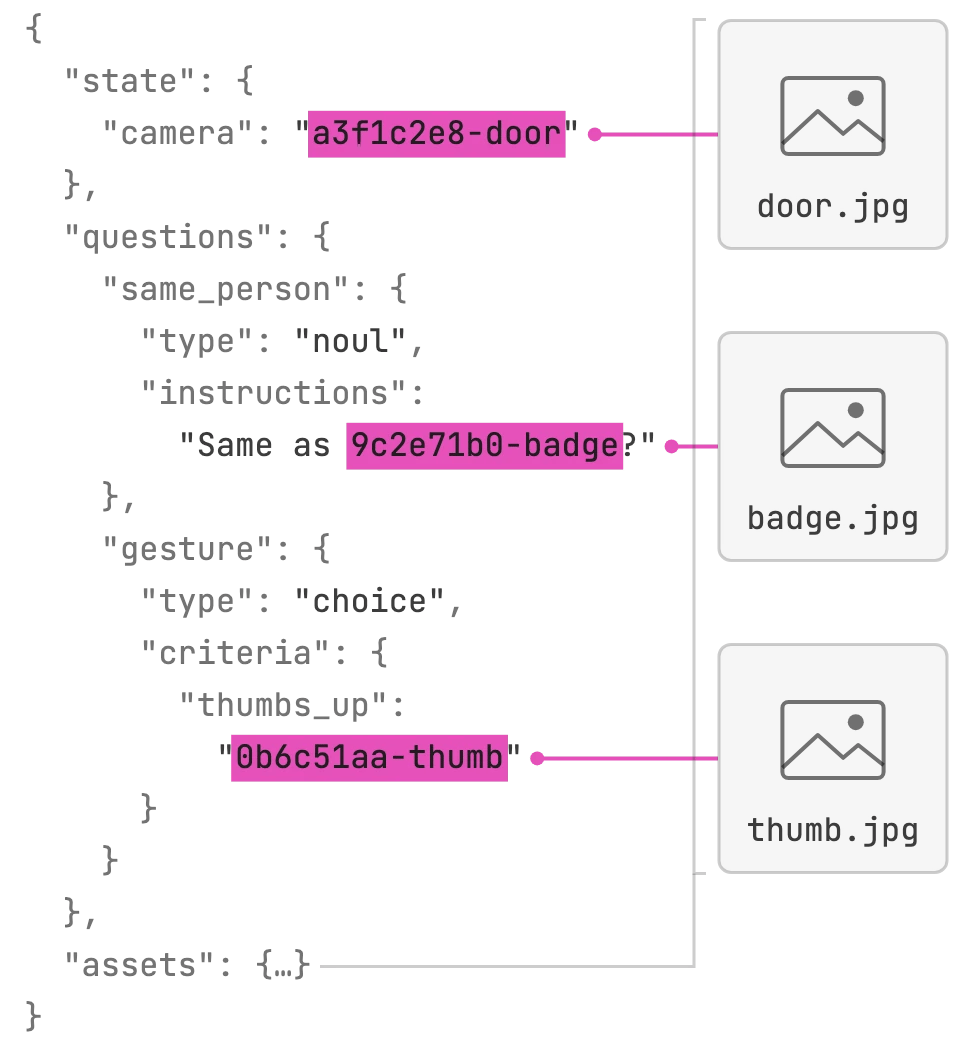
Jevでは、画像を判定対象として渡すだけでなく、質問の指示や判定基準にも含められます。たとえば、ジェスチャーを分類するときに、選択肢ごとの見本画像を基準として渡せます。画像を送るリクエストでは、HTTPヘッダーに TypeSafe-Danger-Zone-Images: true を指定します。
新しい回答型「box」は、画像内から自然言語で指定した対象を探し、その周囲を囲む長方形の座標を返します。座標は画像の幅と高さに対する0から1までの割合で表され、1つの質問につき1つの領域が返ります。この回答型はJev 1.14で利用でき、画像内に対象が見つからない場合も座標を返します。
画像入力とboxはいずれも実験的な機能です。TypeSafe AIは、画像を使うとテキストだけの場合よりモデルの性能が落ちることがあるとして、複雑な判断を単純な質問に分けるよう勧めています。また、対象の有無を別の質問で判定し、その確率が低ければboxの座標を使わない方法も提案しています。
入力上限は条件付きで262kトークンに
通常の入力上限は、入力データとすべての質問を合わせて64kトークンです。また、各質問については入力データとの合計で32kトークンです。Jev 1.13と1.14のどちらも、リクエストに TypeSafe-Danger-Zone-Long-Context: true を付けると、両方の上限が262kトークンになります。
TypeSafe AIは、従来の上限を超える入力も処理できる一方、入力が長くなるほど判断の信頼性が下がるとして、情報を絞ってコンテキストを短く保つよう勧めています。長いコンテキストでは応答も遅くなります。そのため、262kトークンは既定の上限を置き換えるものではなく、指定時に使える実験的な上限です。
文章生成型AIと異なる「System One」
Jevは、TypeSafe AIが「System One」と呼ぶ、ソフトウェアが直接使える形式で判断を返すモデルです。一般的な大規模言語モデルが人向けの文章を生成するのに対し、Jevは状態と型付きの質問を受け取り、構造化された回答を返します。TypeSafe AIは、モデルの設計を自動化に特化させたと説明しています。
回答には型付きの値や確率分布が含まれ、ソフトウェアは結果を解析し直さずに、分岐や並べ替え、振り分けに利用できます。質問には、選択肢から答えるもの、基準に沿って採点するもの、記述が正しいかを判定するものなどがあります。複数の質問を1回のAPI呼び出しで並行して評価します。
この設計は、文章の生成よりも、分類やルーティング、スコア付けなど、ソフトウェアの処理に渡す判断に向いています。複数の要素をまとめて判断させる場合は、質問を個別に分け、結果をコード側で組み合わせる方法が示されています。
多言語改善とモデルの切り替え
TypeSafe AIはJev 1.14でモデル全体に小幅な改善を加え、多言語対応で最も大きな改善を見込んでいます。プレビュー版を指定する jev-preview はすでに jev-1.14.0 に切り替わり、最新安定版を指定する jev-latest も発表から1週間後に切り替える予定です。jev-1.13.0 は引き続き提供されます。
同社は、Jevとオープンウェイトモデルを比べた内部評価も公開しました。評価には自社モデルに有利な偏りがあり得るとして、利用者自身の用途に合わせて試すよう促しています。また、利用者が任意で有効にできる機能を追加し、有効時には送信クエリを問題発見やデバッグに利用するとしています。クエリはモデルの学習には使わないとしています。