TopicBase
MetaのAI研究組織Meta Superintelligence Labは、軽量AIモデル「Muse Ember」を公開しました。入力料金は100万トークン当たり0.10ドル(約16円)で、大規模モデルが立てた計画に沿って、多数の作業を実行する用途を想定しています。
大規模モデルが計画し、Emberが大量の処理を担う
Emberは、ツールの呼び出し、プログラミング作業の一部、処理の振り分け、情報抽出、長い文書の解析などを対象としています。Metaは、自社のAIモデルの中で最も軽量で、費用効率が高いモデルと位置づけています。
想定する使い方は、ツールを使いながら作業を進めるAIエージェントの中で、大規模モデル「Muse Wonder」と組み合わせる構成です。顧客対応なら、大規模モデルが問題の処理方針を定め、軽量モデルがその方針を数万件の案件に適用する役割分担になります。
Emberは、文字だけでなく画像や音声も扱えるよう訓練されています。Metaは、スクリーンショット、グラフ、スキャン文書の読み取りに加え、音声メモ、会議録音、動画を使う作業も、別のモデルを用意せずに処理できるとしています。
Museブランドでは、4月に中規模モデルのSpark、8月にそのオープンソース版のGlimmer、10月に大規模モデルのWonderが登場しており、Emberは4番目のモデルです。一般利用者向けのMuse Agentは9月に公開され、11月に入ってSpacesやビデオチャットの機能追加も進んでいます。
比較に使う評価は、業務の実行や長文処理も対象
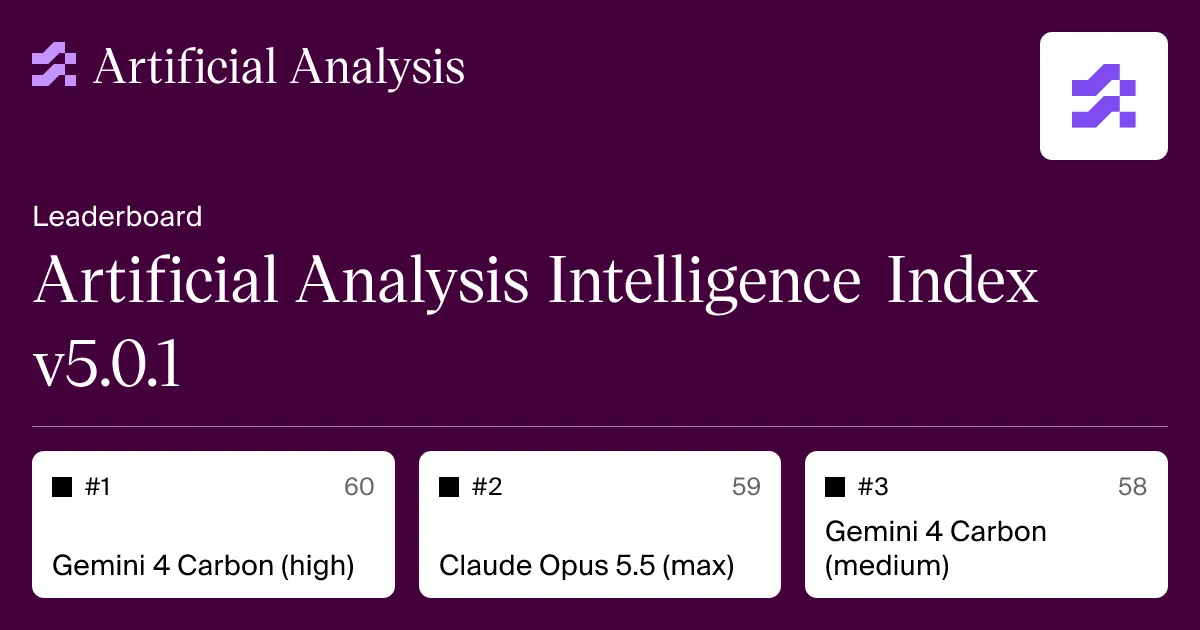
MetaはEmberの費用効率を示す際、AIモデルを評価するArtificial Analysisの総合指標「Intelligence Index」を使い、AnthropicのHaikuやOpenAIのLunaと比較しています。Metaは入力単価に加え、タスクを完了するまでの費用を重視しています。
Artificial AnalysisのIntelligence Index v5.0.1は、知識を使う業務、プログラミング、科学、一般知識にまたがる9種類の評価を組み合わせた指標です。各評価はArtificial Analysisが独立して実施しており、業務自動化を測るAutomationBench-AAや、端末上の作業を測るTerminal-Bench 4.0、PDFを扱うGDP.pdfなどを含みます。
Emberが対象とするツール利用に関わる評価の一つが、AutomationBench-AAです。財務、人事、マーケティング、運用、営業、サポートにまたがる657件の課題で、エージェントが模擬業務アプリのAPIを見つけ、複数のアプリにまたがって作業を実行します。Artificial Analysisは達成した目標の割合を採点し、守るべき制約に違反した課題は0点にしています。
プログラミングの実行面を測るTerminal-Bench 4.0では、ソフトウェアや機械学習、科学、運用、セキュリティーなどの複雑な作業を端末上で行います。Artificial Analysisは66課題をそれぞれ3回実施し、1回の試行で成功する割合の平均を報告しています。
GDP.pdfは、長い財務書類や契約書、PDFの報告書などを読み、複数の文書の内容を踏まえて推論する能力を評価します。
タスク費用は入力・出力などの使用量から計算
Artificial Analysisが使うタスク当たり費用は、入力、キャッシュから再利用した入力、キャッシュへの書き込み、推論、回答の各トークン料金から計算します。評価ごとの費用を課題数で割り、Intelligence Indexでの重みに応じて集計する方式です。
ここでいうトークンは、AIが文章を処理する際の単位で、文字や単語の一部、句読点などに対応します。OpenAIのAPIでは、入力、キャッシュされた入力、出力で料金区分が分かれ、利用者に見える回答以外の内部推論トークンも出力使用量に含めて課金されます。
OpenAIの推論モデルも、回答を出す前に内部推論トークンを使い、計画、ツール利用、複数段階の問題解決を進める仕組みを採っています。
計画と実行を分ける構成には研究例も
WonderとEmberの役割分担に共通する研究例として、KAISTと延世大学の研究者らによる「COPE」があります。COPEは、一方のモデルが作った計画を別のモデルに渡して実行する仕組みで、小規模モデルによる計画と実行から始め、必要に応じて大規模モデルへ計画、実行の順に処理を移します。
研究チームは、数学の評価用データセットMATH-500で、COPEの正答率が75.8%、比較対象のGPT-4oが75.2%となり、有料API費用を約45%減らしたと報告しています。コード生成の評価MBPPでは、正答率がCOPEで66.4%、GPT-4oで64.0%となり、有料API費用は約75%減ったとしています。
COPEでは、計画をモデル間で受け渡すために、課題ごとの追加学習を必要としない構成を採っています。研究チームは数学、コード生成、自由形式の生成、順序立てた意思決定を対象に、規模の異なるモデルを組み合わせる方法を検証しました。