 TopicBase
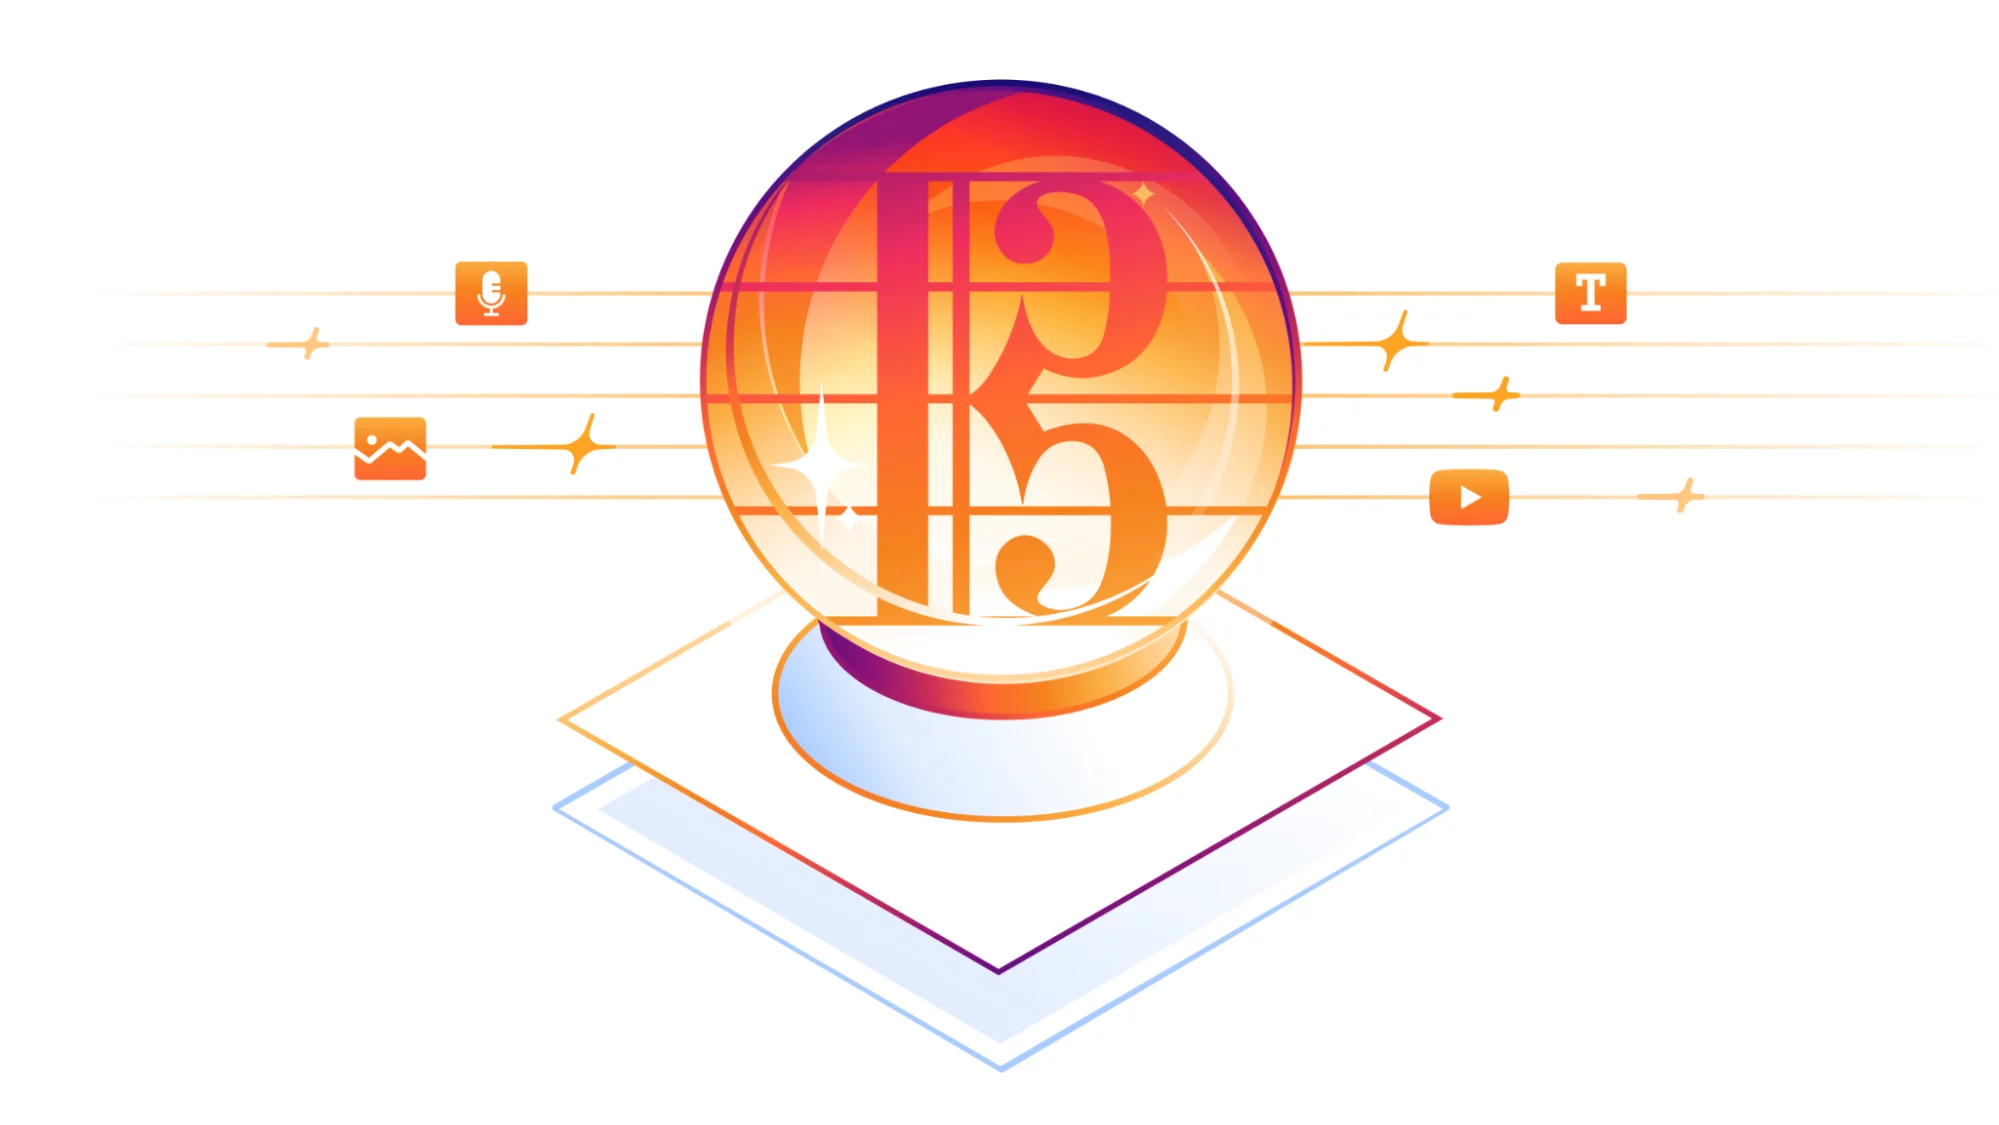
Cloudflareは、音声と動画をテキスト、画像とともに入力できるオープンウェイトモデル「Clef-omni」を公開しました。従来のClefに音声・動画を加え、複数の入力形式を一つのモデルで扱えるようにしました。あわせて、Clefの処理速度を上げ、Clef-flashの価格を引き下げました。
Clef-omniが扱う入力形式
Clef-omniは、音声ファイルのWAVとMP3、動画ファイルのMP4とWebMに対応します。テキストと画像も入力でき、映像や音声の内容を文章の指示と組み合わせて処理できます。
Cloudflareは、音声を先に文字起こししてから別のモデルに渡したり、動画から音声と画像を分離したりする複数段階の処理を、単一モデルへの呼び出しに置き換えられると説明しています。たとえば、機器の写真、稼働音の録音、ファンを映した動画を一緒に渡し、設置状況を確認するよう指示する例を示しました。
こうした入力の種類を「モダリティ」と呼びます。マルチモーダルAIは、テキストや画像、音声など異なる種類の情報を複数扱うAIを指します。一般的な仕組みでは、画像から物体や色、音声から言葉や調子などの特徴を取り出し、それらを組み合わせて処理します。
複数モデルをつなぐ方式との違い
音声認識モデルと文章を扱うモデルを順番につなぐ方式では、最初のモデルが音声をテキストに変換し、その結果を次のモデルに渡します。WhisperとGPT-4oを組み合わせる方式は、音声をテキストに変換してから推論する構成の例です。
一つのモデルが複数のモダリティを扱う方式では、音声を文字に変換してから別モデルに渡す段階を省けます。Cloudflareは、Clef-omniなら音声や映像を分けて別々のモデルに処理させる代わりに、一度の呼び出しで判断できるとしています。
動画モデルには、フレーム(映像を構成する静止画像)に分けて扱うものと、長い動画の時系列理解を得意とするものがあります。Cloudflareは今回、Clef-omniが動画を内部でどのように処理するかを公表していません。
「判断」に特化したモデルという位置づけ
Cloudflareは、Clefを「decision model(判断モデル)」の分野に位置づけています。これは、文章を自由に生成する一般的なチャット向け大規模言語モデルとは異なる目的を持つモデル群です。Jevは、状態と型付きの質問を受け取り、選択肢や尺度に沿った回答と確率を返す設計です。
Jevでは、質問への回答形式をあらかじめ定めます。選択肢から選ぶChoice、順序のある尺度で評価するScore、ある命題が正しいかを確率で返すNoulが用意されています。これにより、ソフトウェアが回答をそのまま扱いやすくすることを目指しています。
Jevはチャットの返答やコード、判断理由の説明を生成せず、決められた形式の判断を返すモデルとして紹介されています。これはJevの説明であり、Clef-omniも同じ仕組みを備えるという意味ではありません。Cloudflareが今回示したClef-omniの変更点は、判断モデルに音声と動画の入力を加えたことです。
Clefファミリーの変更
CloudflareはClef-omniの公開に加え、Clefの速度を改善し、Clef-flashの価格を引き下げました。Cloudflareは価格がJevより安いとしていますが、具体的な料金額は公表していません。
Clef-omniの重みはHugging Faceで公開され、Cloudflare Workers AIでも利用案内が提供されています。開発者向けには、音声や動画を含む入力をAPIへ送る例も示しました。