TopicBase
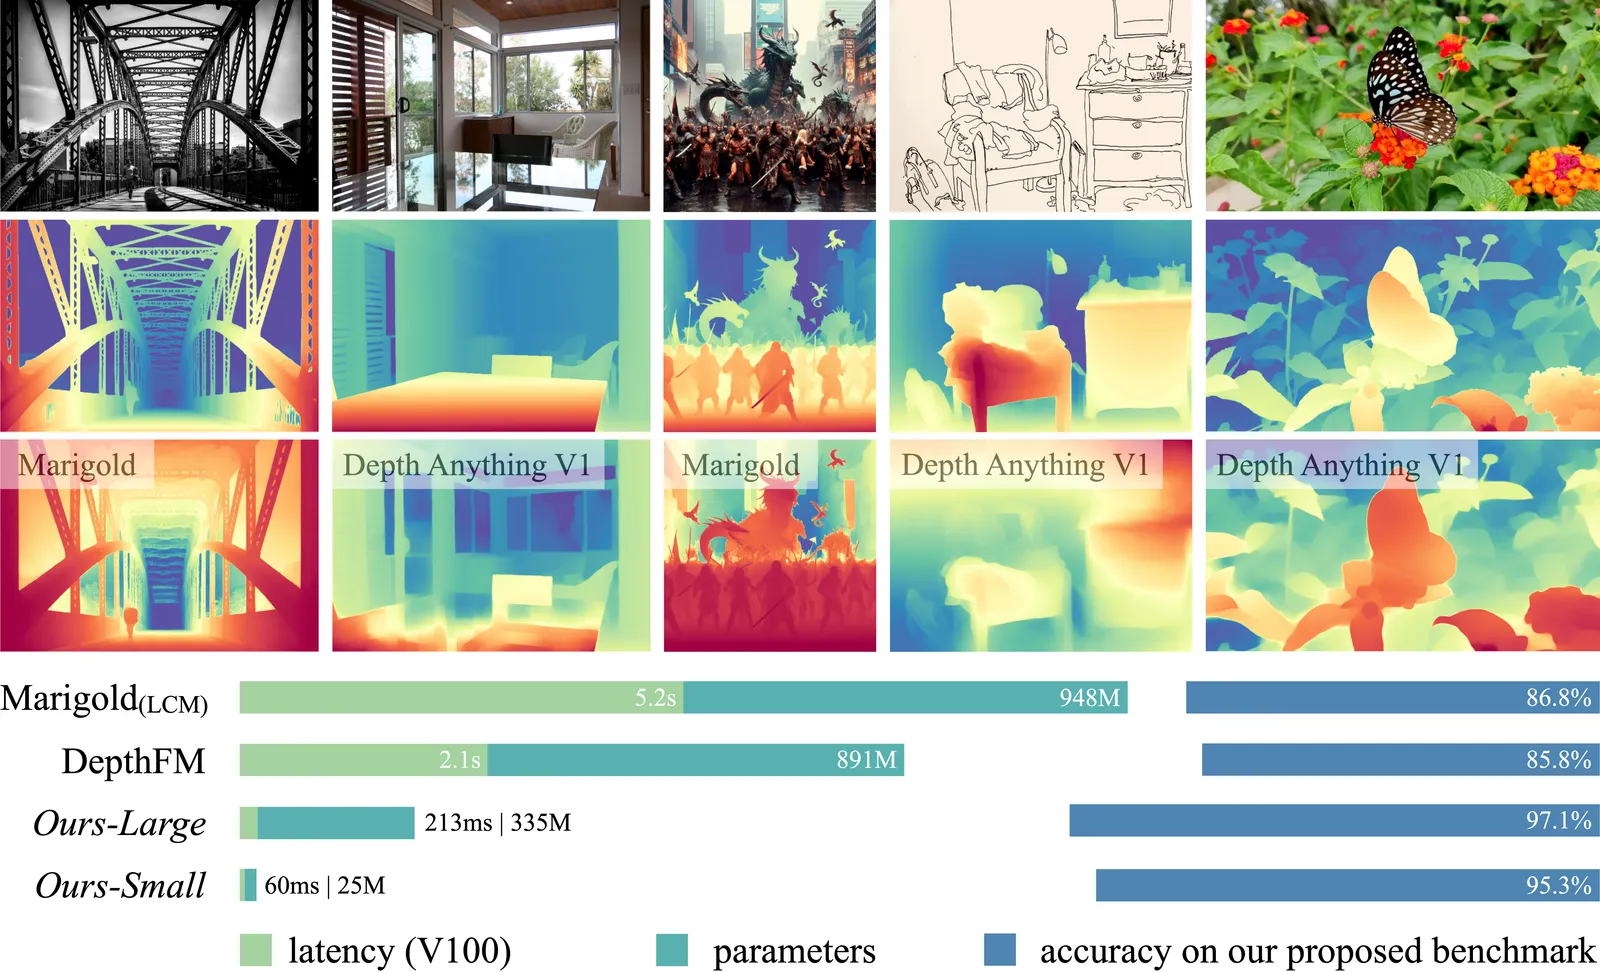
重みの一部を編集し、深度エッジ検出の改善を報告
X上の投稿は、Depth Anything V2 Largeの重みを直接編集し、実際の深度エッジ検出数が41%増加したと報告しました。編集した重みは全体の約0.35%としています。
深度エッジは、画像内で物体までの距離が急に変わる境界などを指します。投稿は、改善対象をエッジ検出に絞り、モデル全体を作り直さずに一部の重みを変更する方法を示しています。
再現手順として、投稿はrefinenet1とrefinenet2にある特定の畳み込み層の3×3カーネルを取り上げました。カーネルを、一定値と左右・上下方向の傾きを表す滑らかな成分に分ける操作を案内しています。
学習をやり直さずにモデルの重みを変える
Weight-Space Programmingは、大規模言語モデル(LLM)がニューラルネットワークの重みを直接読み書きし、自然言語で指定された目標に沿って変更する手法です。通常の勾配降下法などの最適化器を介さずに重みを編集する点が特徴です。
この手法では、モデルの重みの構造を調べ、特定の動作を担う部分を推定して変更します。Sparks of Weight-Space Programmingの実験では、モデルの重みを読み取る課題や、小規模なネットワークの重みを新たに作る課題も扱われています。
Depth Anything V2 Largeの投稿は、エッジ検出を目標に重みの一部を編集した事例です。
別のモデルでも報告された小規模な重み編集
Hugging Faceで公開されたGemma 4 E4B向けのパッチは、モデルの重みの0.00205%にあたる163,840個のパラメーターを編集すると説明しています。勾配降下法やファインチューニングを使わず、特定の層にあるMLPの列を変更する構成です。
公開されたベンチマークでは、8件の検索課題における有効なツール呼び出し率が、編集前の0%から編集後の75%になりました。段階的な数学問題では、420トークン以内に解けた割合が33.3%から66.7%になったとされています。
この例はDepth Anything V2 Largeとは別のモデルで、変更箇所も評価課題も異なります。モデルと評価課題が異なるため、報告された数値は直接比較できません。
深度エッジがロボットの認識や把持に関わる
深度画像のエッジは、物体の境界や前後関係を見分ける手がかりになります。遮蔽エッジは、物体認識、把持、障害物回避、経路計画などに使われます。
別の研究では、単一視点の深度画像から得たエッジを使い、物体の接触候補を探してロボットの把持姿勢を計算しました。対象物の形状や位置を踏まえた把持に深度エッジを使う例です。
その研究のシミュレーションでは、ロボットの6次元姿勢を生成する処理に平均281ミリ秒かかったと報告されています。Depth Anything V2 Largeの投稿が示す検出数の増加は、こうしたエッジ利用の研究と関連する指標です。