TopicBase
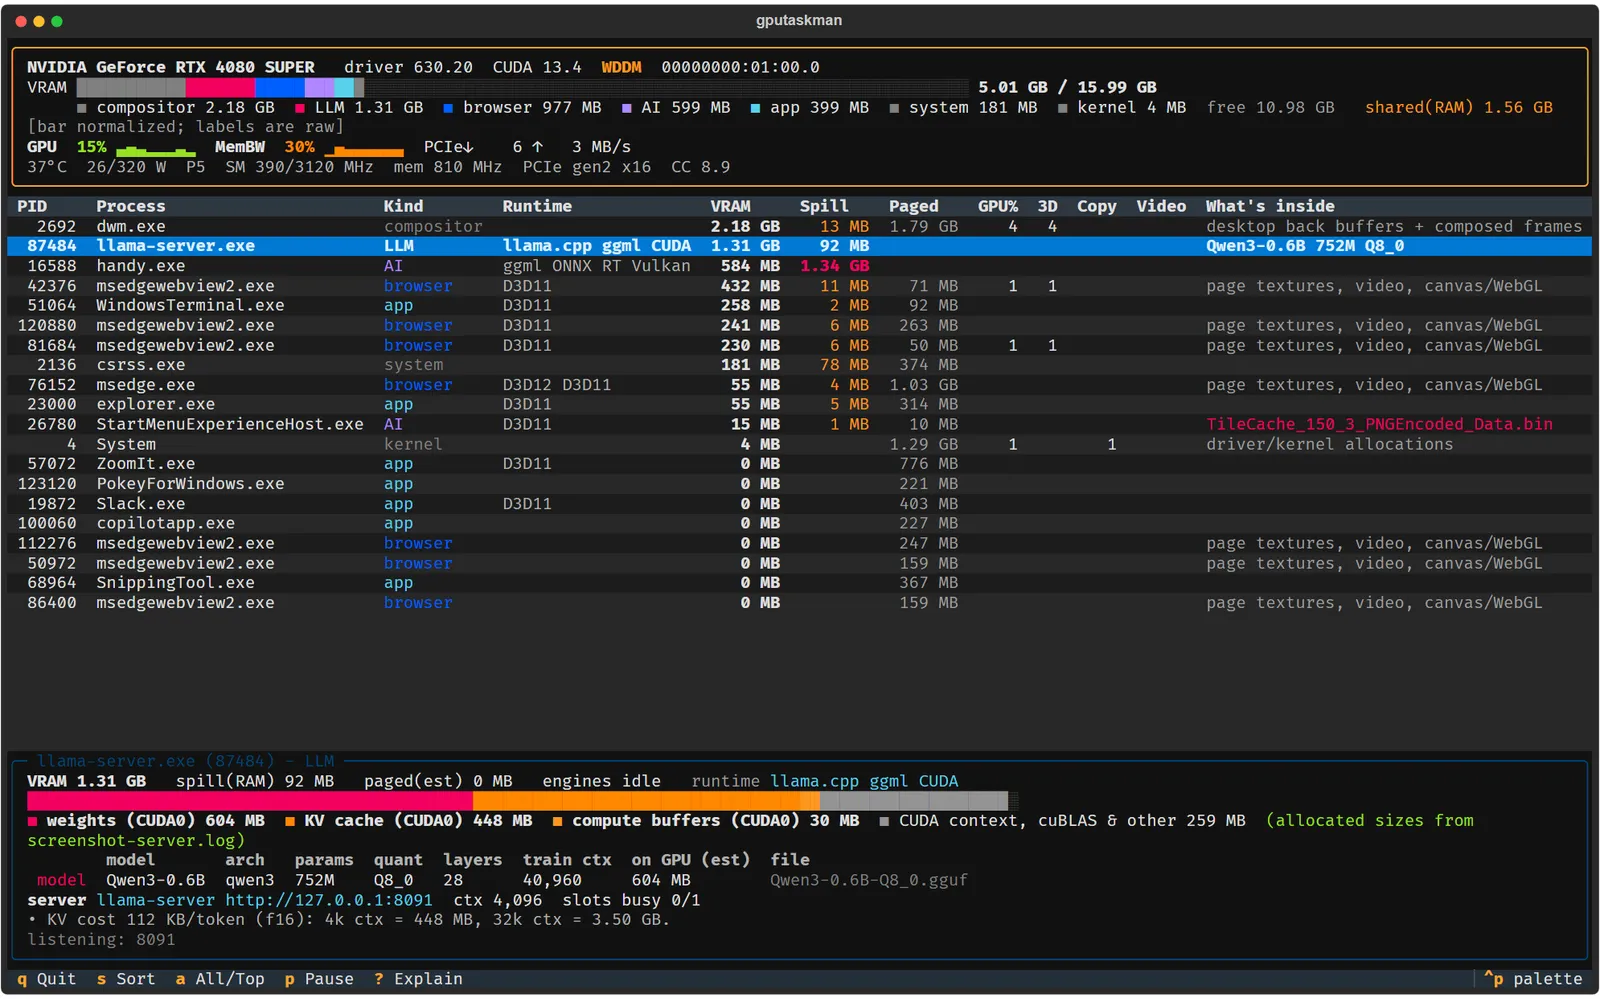
GPUを使うプロセスとモデル情報を一覧化
「gputaskman」は、GPUの使用状況をプロセスごとに表示するターミナルツールです。VRAM(GPU専用メモリー)の使用量やGPUエンジンの稼働状況に加え、読み込まれた実行環境やモデルファイル、LLMの重みとKVキャッシュの内訳を関連付けて表示します。
WindowsではNVIDIAとAMD、LinuxではNVIDIAとAMD、WSL(Windows上でLinuxを動かす環境)ではNVIDIAに対応します。macOSではApple Siliconをサポートし、対象はクラウドではなくローカルのGPU処理です。
Windowsのタスク マネージャーがGPUメモリーの使用量を示す場面で、「gputaskman」はプロセス別の使用量やエンジン負荷、モデル関連の情報を同じ画面で確認できます。GPUを使うブラウザーやデスクトップ表示のプロセスも対象です。
プロセス別表示とモデル特定の仕組み
LinuxではNVIDIAのNVMLから実行中の計算・描画プロセスのメモリー量を読み取り、GPUの演算、エンコード、デコードの負荷を利用率サンプルから取得します。AMDのネイティブLinux環境では、カーネルが公開する情報を使ってVRAMやGTT(GPUから利用できるシステムRAM)、エンジン負荷などを扱います。
コンテナー内では、NVMLが返すホスト側のプロセスIDとコンテナー内のプロセスを対応付けます。対応の確度に応じて表示に印が付き、別のコンテナーなどに属するプロセスはコンテナー内で照合しません。
モデル名や処理内容の識別には、実行中のプロセス情報や読み込まれたファイルなどの根拠が必要です。PyTorchやCUDAのライブラリーがあるだけでは特定のモデルや学習処理の証拠にならず、モデルファイルが見えてもGPU上で使われているとは限りません。
タスク マネージャーやnvidia-smiとの違い
「gputaskman」は、プロセス別のGPUメモリーとエンジン負荷に、実行環境、モデルファイル、LLMの重み・KVキャッシュの内訳を関連付けて表示します。これにより、メモリーを使うプロセスだけでなく、モデル関連の手掛かりも一緒に確認できます。
コンテナー環境では、nvidia-smiのようにNVMLを使うツールはGPUデバイスを開いてもlibcuda.soを読み込まないため、プロセスの対応付けに使う対象から区別されます。「gputaskman」はlibcuda.soを読み込んだプロセスを手掛かりに、NVMLのホスト側プロセスIDとコンテナー内のプロセスを照合します。
Windowsでは、表示する値に専用GPUメモリーや共有GPUメモリー、コミット済みメモリーがあります。WindowsのGPUメモリー管理機構は、GPUが利用できるシステムRAMの上限や、GPU用に確保できるメモリー量を計算します。
GPUは仮想アドレスを通じてローカルのビデオメモリーとシステムメモリーのどちらにもアクセスできます。統合GPUではCPUとGPUが同じシステムメモリーを使う方式もあり、表示されるメモリー区分を読む際は、GPUの構成と実行環境が関係します。
測定値と推定値、導入方法
デバイスやプロセスのカウンターは測定値ですが、プロセスの分類やGGUF形式のモデルファイルから算出する内訳は推定値です。Linuxでは共有メモリーやコミット値に相当するカウンターを取得できない場合があり、取得不能な値はゼロではなく空欄またはJSONのnullとして扱われます。
AMDのネイティブLinux環境では、共有バッファーや複数プロセスで共有されるクライアントなど、所有者を一つに特定できないメモリーを個別プロセスの使用量として割り当てない仕組みです。その場合は使用量が未確定として扱われ、共有分をプロセス間で二重計上しません。
PyPI版はPython 3.11以降の環境で導入でき、uvまたはpipxを使う方法が案内されています。Windows向けにはPython不要のポータブル版もあり、現在の配布ビルドは署名されていません。