TopicBase
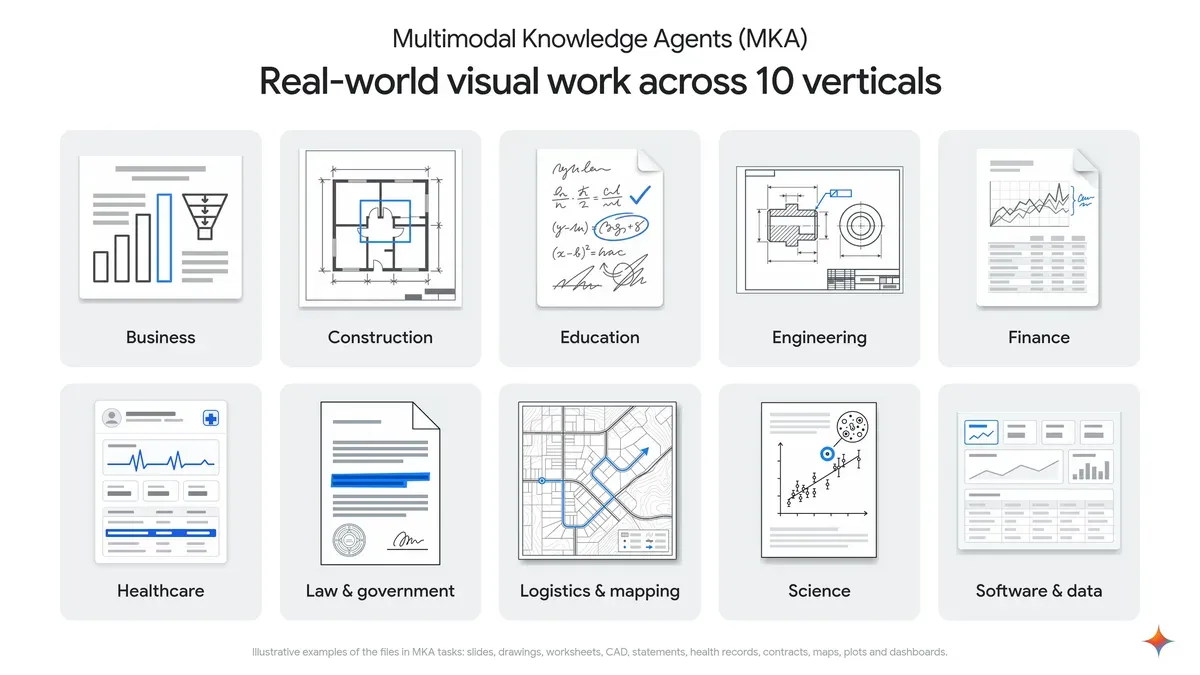
GoogleはArtificial Analysisと共同で、視覚情報を扱うAIエージェントの業務遂行能力を測るベンチマーク「Multimodal Knowledge Agent(MKA)」を公開しました。図面や画像など複数のファイルを読み解き、成果物を作るまでの作業を、10分野・83職種にまたがる200課題で評価します。
Googleの評価では、AIモデル「Gemini 4 Carbon」がテスト対象の中で品質2位となりました。評価用の200課題は非公開とし、別に10課題を公開しています。Gemini 4 CarbonはGoogle AI StudioのGemini APIから利用できます。
図面の読解から文書・表計算ファイルの作成まで評価
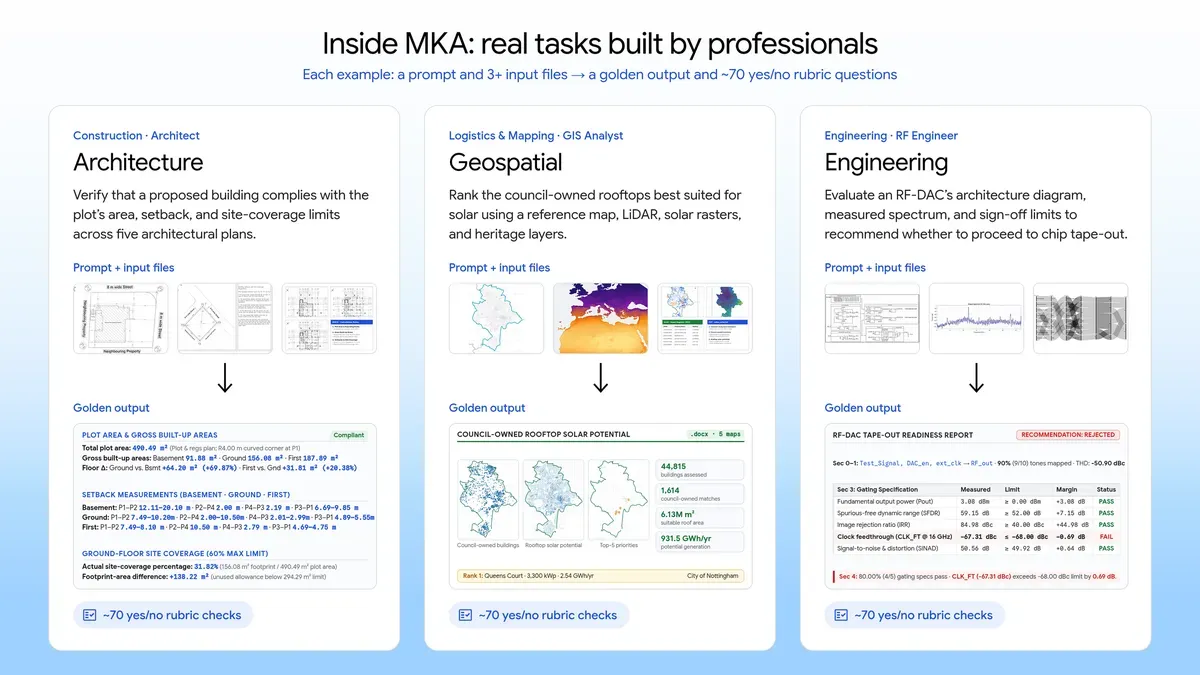
MKAの対象は、AIがツールを使って複数の手順を進める業務です。建築家、生物学者、保険の引受担当者、データサイエンティストなどの専門家が課題作成に参加しました。各分野に20課題を配し、作成者とは別の同職種の専門家が、現実の業務としての妥当性と正確さを確認しています。
1課題には2〜45個の入力ファイルがあり、縮尺付きの平面図、電子回路図、経路図、医用画像などを組み合わせて扱います。課題の88%では、表計算、スライド、PDF、文書、HTML、画像など、単独で利用できるファイルの提出が必要です。
採点には、専門家が作成した約70項目の「はい・いいえ」で判定する基準を使います。配点は事実の正確さが75%、視覚的なデザインが25%です。入力内容の理解に加え、成果物の内容と見た目も評価します。
Google DeepMindの実験では、Gemini 4 Carbonから画像閲覧ツールを外しても、業務遂行能力を測る既存ベンチマーク「GDPval」の品質と計算量は変わりませんでした。一方、MKAでは難しい評価項目のスコアが約5.9ポイント下がり、処理の反復回数は1.28倍、出力トークン数は1.40倍になりました。
GDPvalにも、業務上の指示や参照ファイルを基に成果物を作る課題があります。評価ツール「EvalScope」が扱う公開版は220課題で、監査対象の表計算ファイルから標本を選び、計算過程を含む新しい表計算ファイルを作る例があります。MKAはこうした成果物作成に加え、テキスト化すると重要な情報が失われる図面や画像を、複数ファイルにまたがって読み解く構成です。
共通の実行環境で比較し、成果物を自動採点
各モデルは、オープンソースのエージェント実行基盤「Stirrup」で動きます。利用できるツール、隔離された実行環境であるサンドボックス、処理の反復回数の上限をそろえて評価します。
Stirrupは、モデルの応答生成、ツールの実行、実行結果の履歴への追加を、タスクが完了するまで管理する仕組みです。入力ファイルの受け渡しや出力ファイルの保存、ツールの準備と終了処理も担います。JavaScript版のStirrupJSでも同様の実行ループを使い、完了の通知や設定した反復回数への到達などを条件に処理を終えます。
MKAの自動採点に使うのはGoogle以外のモデルです。採点用のエージェントは成果物の各ファイルを開き、文書を描画して確認するとともに、表計算の数式なども調べ、専門家の基準に照らして判定します。人間の専門家による検証は50課題で行われました。
評価用の200課題はArtificial Analysisが管理し、学習データへの混入や検索による課題の発見を防ぐために非公開としています。別に公開された10課題は、AI関連のデータやモデルを共有するHugging Faceで入手でき、課題の形式の確認や独自エージェントの試験に使えます。
難しい評価項目では上位モデルも達成率57%未満
Google DeepMindは、評価項目ごとの配点を反映した達成率を「Overall WSR」、旧世代モデルでは達成が進んでいない評価項目に絞った達成率を「Climb-WSR」として集計しました。
Google DeepMindの評価では、Claude Fable 5.2のOverall WSRは73.3%、Climb-WSRは56.6%でした。Gemini 4 Carbonはそれぞれ71.9%、54.3%で、難しい評価項目の達成率は最上位でも57%を下回りました。テスト対象のモデルが1課題に使った処理の反復回数は、平均30〜130回と幅があります。
自動採点では自己優遇と判定の偏りも研究対象に
MKAのように基準ごとの可否をAIに判定させる方式では、採点役の特性も研究されています。José Pombal氏らは、採点役が自分自身や同系列のモデルの出力を優遇する「自己優遇バイアス」が、客観的な基準を使う採点でも生じると報告しました。
José Pombal氏らの研究では、基準を満たしていない出力について、採点役自身の出力だと誤って合格にする確率が50%超高くなる場合がありました。複数の採点役を組み合わせる方法は偏りを軽減したものの、完全には解消しませんでした。
また、Stephane Collot氏らは、モデルの成功率などを比較するための採点役を選ぶ際、通常の正解率は合格・不合格の比率に左右されると論じています。両方の判定を等しく重視する「Balanced Accuracy」を推奨しており、この評価方法はMKAで使われるような項目別の自動判定にも関わります。