TopicBase
Googleは、AI向け専用プロセッサー「TPU」の第8世代に、機密データを扱う推論向けの「TPU 8tx」と、大量の文脈を処理する「TPU 8i Max」を追加しました。既存の学習向け「TPU 8t」、低遅延の推論向け「TPU 8i」と合わせ、同社が1年に4つのTPUシステムを投入するのは初めてです。新たな2構成は、処理中のデータ保護と、長い文脈を扱う際のメモリ制約にそれぞれ対応します。
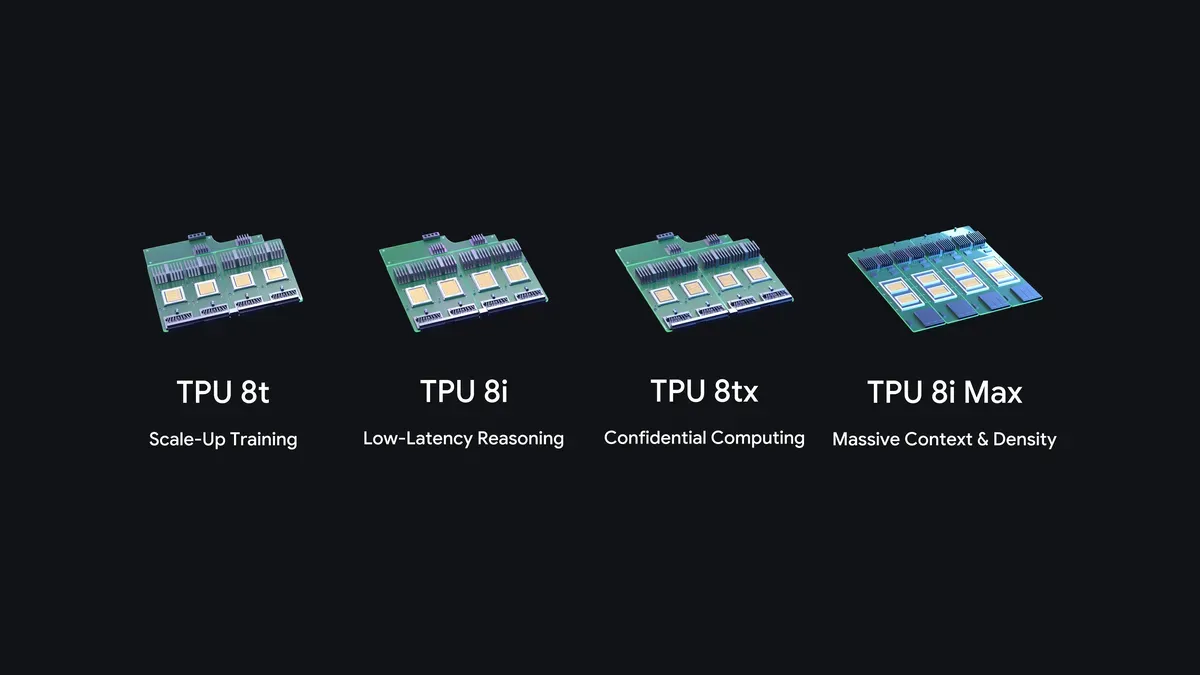
同じ世代のチップを用途別のシステムに構成
今回追加されたのは、チップを核に計算資源、ネットワーク、記憶装置などを組み合わせたシステムです。Googleは、TPUを構成要素として、実装方法や高速メモリ、光ネットワーク、セキュリティを調整する設計を採用しています。
第8世代では、大規模モデルの学習をTPU 8t、低遅延の推論をTPU 8iが担います。Googleは、前世代に対してTPU 8tの学習性能は最大2.7倍、TPU 8iの推論の価格性能比は80%向上したとしています。新構成は、こうした基盤を、複数段階の作業を進める自律型AIエージェントなどの用途に合わせて組み替えたものです。
TPU 8txは処理中のデータとモデルを保護
TPU 8txは、TPU 8tと同じ半導体を使い、第5世代AMD EPYC CPUをホストとして組み合わせます。規制の厳しい企業や政府機関を想定し、機密性の高いデータとともにAIモデルや自律型AIエージェントを動かす構成です。Googleは、ハードウェア層でデータとモデルの重みを隔離し、使用中も保護するとしています。
ネットワークには、TPU 8iで使う低遅延の「Boardfly」を採用します。Googleは、TPU 8tに比べて遅延を最大で半分に抑え、機密保護による性能への影響もほぼ生じないとしています。同じシステムでモデルを動かしながら、非公開データによる追加学習、大きなモデルの知識を小さなモデルに移す「蒸留」、報酬を使って行動を学ばせる強化学習にも対応します。
TPU 8txが対象とするコンフィデンシャルコンピューティングは、保存時・通信時の暗号化に加え、使用中のデータを保護する技術です。一般的な仕組みは、処理を隔離する信頼実行環境「TEE」と、その環境や実行内容が正しいかを遠隔で検証する「リモートアテステーション」を組み合わせます。
フランスの国家サイバーセキュリティ機関ANSSIは、この技術を多層防御の一部と評価する一方、悪意ある管理者による標的型の能動的攻撃に対し、データの機密性と完全性を十分に守れるものではないとしています。また、Confidential Computing Consortiumは、TEE内で動く処理でも、ログや外部とのデータ交換、漏えいした認証トークン、ビルドや依存ソフトの問題が保護を損なうと指摘しています。
TPU 8i Maxは計算能力とメモリ帯域を同時に拡張
TPU 8i Maxは、2つのTPU 8iチップを1つのパッケージにまとめた構成です。Googleは、TPU 8iに対して計算能力、チップ内の高速メモリであるSRAMの容量、広帯域メモリ「HBM」の帯域をそれぞれ2倍にするとしています。既存のラック設置面積に2倍の半導体を収め、ラック当たりの計算密度を高める設計です。
対象は、複数のエージェントがソフトウェアのコード全体や数時間分の動画を同時に扱うような処理です。Googleは、100万トークン規模の文脈を扱う際のメモリ制約への対応に位置づけています。トークンは、モデルが文章などを処理する際の単位です。
大規模言語モデルの推論には、入力をまとめて処理する「プリフィル」と、出力を順番に生成する「デコード」があります。プリフィルは計算能力を多く必要とし、デコードでは過去のトークンから計算した情報を「KVキャッシュ」として再利用します。文脈が長くなると再利用する情報も増え、デコードはメモリの容量やデータ転送帯域による制約を受ける仕組みです。
このため、TPU 8i Maxが計算能力とメモリ帯域を同時に増やす構成は、長い文脈の処理で生じるデータ移動の制約に対応します。LLM推論の入出力を扱う研究でも、モデルの重み、KVキャッシュ、中間計算データの移動が性能を左右する要素に挙げられています。
PyTorch対応とメモリ管理ソフトも拡充
Googleはハードウェアと並行して、機械学習フレームワーク「PyTorch」向けの実行環境も拡充しています。GoogleとMetaが協力するオープンソースのは、PyTorchをTPU上で直接動かすバックエンドで、命令を順次実行するイーガー実行と、処理をコンパイルして実行する方式の両方に対応します。
従来のPyTorch/XLAは、命令を計算グラフに蓄積してからコンパイルする遅延実行が基本で、グラフや入力形状が変わるとコンパイルが発生します。TorchTPUは、対応演算や分散実行の統合を進めており、カスタムカーネルの作成にはJAX/PallasやHelion DSLを利用できます。開発チームは、移植時のコード変更を小さくする方針を掲げつつ、最高性能を得るにはモデルの形状や処理の分割、演算がTPUに合っているかが関わるとしています。
新しいオープンソースのTPUエージェントスイートはプレビュー段階で、Claude Code、Cursor、Google Antigravityなどの開発ツールと接続し、導入支援やボトルネック診断、カスタムカーネルの自動調整を行います。「XLA Serving Engine」は、Pythonで学習したモデルを低遅延のC++実行環境で動かし、TPU、GPU、CPUに対応します。
Googleは、vLLMとTorchTPUを組み合わせた構成が、エージェントによるコーディングや長い文脈の処理を評価するInferenceX、AgentXで最先端の価格性能比を達成したとしています。同じハードウェア向けに、今後もソフトウェアの最適化を予定しています。
待機中の資源管理では、「Agent Compute Engine」が外部ツールや人の応答を待つエージェントのセッションを自動停止し、作業用メモリをミリ秒単位でチップ外に移します。オープンソース化する「TPU Sync」は、HBM、ホスト側メモリ、共有ストレージ、ネットワークを一体のメモリ階層として扱う仕組みです。Googleは、KVキャッシュの退避や転送、強化学習用の重みの同期により、KV転送の遅延と最初のトークンが出るまでの時間を90%超削減するとしています。
大規模な分散処理向けの「Cloud Pathways」は、コンテナ管理サービスGoogle Kubernetes Engineで一般提供を開始しました。単一の制御系から複数のTPU群を操作し、事前学習、強化学習、複数ホストでの推論を実行できます。長時間の処理を支える機能として、1分未満でのTPU群の切り替えや、処理の分割配置を動的に変更する仕組みも備えます。