TopicBase
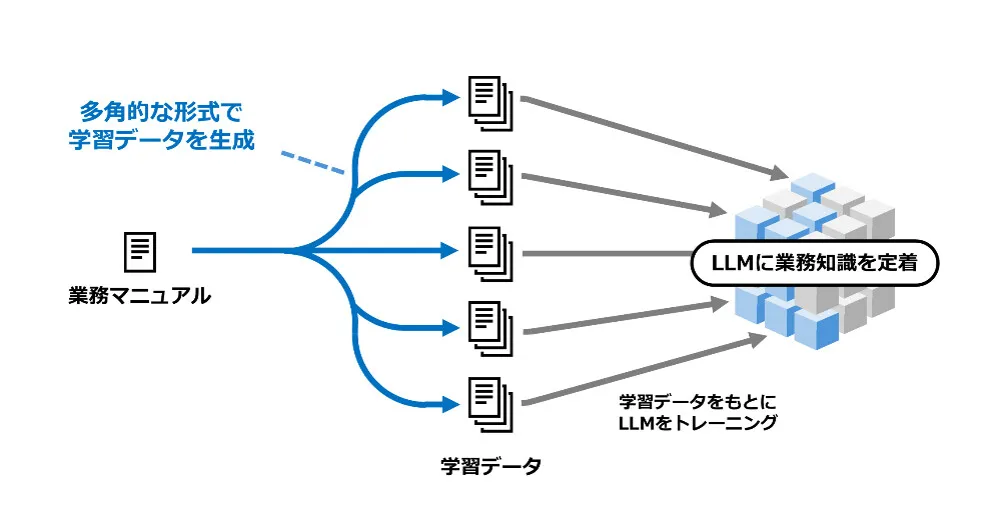
NTTは、少量の業務マニュアルから特定の専門知識を大規模言語モデル(LLM)に定着させるチューニング技術を開発しました。LLM自身がマニュアルを基に多様な形式の学習データを作り、そのデータを使って知識を学ぶ手法です。
NTTの実業務マニュアルを使った実験では、同社のLLM「tsuzumi 2」の正答率が83.1%となり、比較した先行研究の最大73.3%を上回りました。成果は11月18日から25日まで、東京都武蔵野市で開かれるNTT R&D FORUM 2026に展示される予定です。
限られた業務文書から専門知識を学習
LLMは、大量の文章などを学習して言葉を扱うモデルです。チューニングは、既存のLLMを特定の用途やタスクに合わせて調整する作業を指します。今回の技術は、そのうち業務に固有の知識をモデルに覚えさせるためのものです。
業務マニュアルや専門書の内容をモデルに覚えさせるには、モデル全体を再学習させる手法が一般的です。この手法では、数十ギガバイトを超える大量のデータが必要になります。一方、実際の業務現場でそれほど大量のマニュアルや資料を用意するのは困難です。
インターネットから似た情報を集める方法もあります。ただし、業務と無関係な情報が混ざりやすく、質の高い学習データの整備は容易ではありません。そのため、各社が持つ限られた業務資料から効率的に知識を定着させる手法が求められています。
マニュアルからFAQや仕様書を生成
新技術では、問い合わせマニュアルなどを基に、LLM自身が学習用のデータを作ります。元の文書をそのまま繰り返すだけでなく、異なる観点や形式の教材を生成します。生成したデータを使って、モデルにマニュアルの知識を学習させる仕組みです。
生成するデータの例には、仕様書やFAQがあります。FAQは、よくある質問とその回答を整理した形式です。異なる表現形式のデータを使うことで、マニュアルの内容を多角的に学習します。
比較対象の従来手法には、元の業務マニュアルを繰り返し利用する方法があります。先行研究には、文章を数学問題やFAQ、手順書などに言い換える方法があります。想定する読者像に応じて文章を言い換える方法も、先行研究として比較されました。
tsuzumi 2の正答率は83.1%
NTTは、実際の業務マニュアルを使って知識の定着度を測りました。マニュアルに記載された範囲から問題を作成し、LLMに解かせて正答率を調べています。評価にはtsuzumi 2と、より軽量な「Llama 3(3B)」を使いました。
tsuzumi 2の学習前の正答率は65.3%でした。比較した先行研究では最大73.3%となりました。新技術を使った場合は83.1%で、先行研究の最大値を9.8ポイント上回っています。
Llama 3(3B)でも、先行研究より優れた結果が得られました。NTTは、基本的な性能が低くなりがちな軽量モデルほど、特定分野に特化させる必要性が高いと考え、このモデルも評価対象にしました。NTTは、新技術をtsuzumiのほかのLLMにも適用できるとしています。
検索を使うRAGとの違い
企業固有の情報をLLMの回答に使う方法には、検索拡張生成(RAG)もあります。RAGでは、文書検索モデルが外部データベースを参照して回答元の情報を選びます。LLMはその検索結果を基に、文脈に沿った回答を生成します。
今回の技術は、業務マニュアルから作ったデータを使って、知識をモデル自体に定着させます。これに対し、RAGは外部の情報を検索して回答に利用します。RAGでは、データ形式に合わせて、LLMの推論に適した情報を検索する必要があります。
NTTの担当者は、正確性が特に重視される場面ではRAGを推奨する一方、高速な処理が必要な業務ではモデルに知識を定着させる方法に利点があるとしています。モデルが知識を持つことで、外部検索を介さずに推論できるという考えです。また、両手法は併用でき、モデルに備えた前提知識がRAGの検索精度の向上にも役立つとしています。
NTTグループへの導入と展示を予定
新技術は、NTTグループ各社への導入が予定されています。NTTは、用途に応じた複数のチューニング手法を組み合わせる際の一つとして位置づけています。各社固有の業務知識を持つLLMを、従来より少ない準備で構築できるということです。
展示会場は、東京都武蔵野市のNTT武蔵野研究開発センタです。展示期間は11月18日から25日までです。新技術の説明に加え、tsuzumiの用途拡大の経緯も紹介する予定です。
展示では、AIエージェントが能動的に業務を覚えるための技術開発も紹介されます。AIエージェントは、AIを使って作業を進める仕組みです。今回の技術は、業務マニュアルから学習用データを作り、モデルに知識を定着させる工程を担います。