 TopicBase
Preferred Networks(PFN)は10月27日、生成AI基盤モデルの最新版「PLaMo 3.1 Prime」の提供を始めました。Webを自律的に調査して出典付きレポートを作る機能を備え、オンプレミス環境でも利用できます。
Web調査からレポート作成までを自動化
Deep Researchでは、利用者が調査テーマを入力すると、モデルが調査計画を立て、Webから情報を集めて整理・分析し、出典付きのレポートにまとめます。作業には数分から数十分かかります。
市場・競合調査や技術動向の把握など、従来は担当者が数時間から数日かけていた業務の効率化を支援します。新しいPLaMo ChatまたはPLaMo APIから利用でき、APIを通じて自社アプリケーションや業務システムに組み込めます。
Web検索は、質問に応じて最新情報を参照し、出典を添えて回答する機能です。Deep Researchは複数の情報を読み比べ、目次付きの詳しいレポートを作成します。
オンプレミスで社内文書を使った調査にも対応
PLaMo 3.1 PrimeのDeep Researchは、顧客企業が管理するオンプレミス環境にも導入できます。社内文書の検索システムと連携すれば、Web情報と社内文書の両方を調べる構成や、閉域環境内の社内文書だけを対象にする構成が可能です。
オンプレミス型の大規模言語モデルは、自社サーバーやデータセンター内でモデルを動かす方式です。クラウド型のように外部サービスへデータを送る構成とは異なり、社内ネットワーク内で処理を完結させやすく、保管場所や通信経路を自社で管理できます。
ただし、オンプレミスではサーバーなどの初期投資に加え、モデル更新や性能監視、セキュリティ対応を継続する必要があります。大企業向けの構成では、GPUサーバーの調達や運用人材の確保が課題になり得るほか、導入後の保守体制も検討事項です。
事実性や応答速度の改善を掲げる
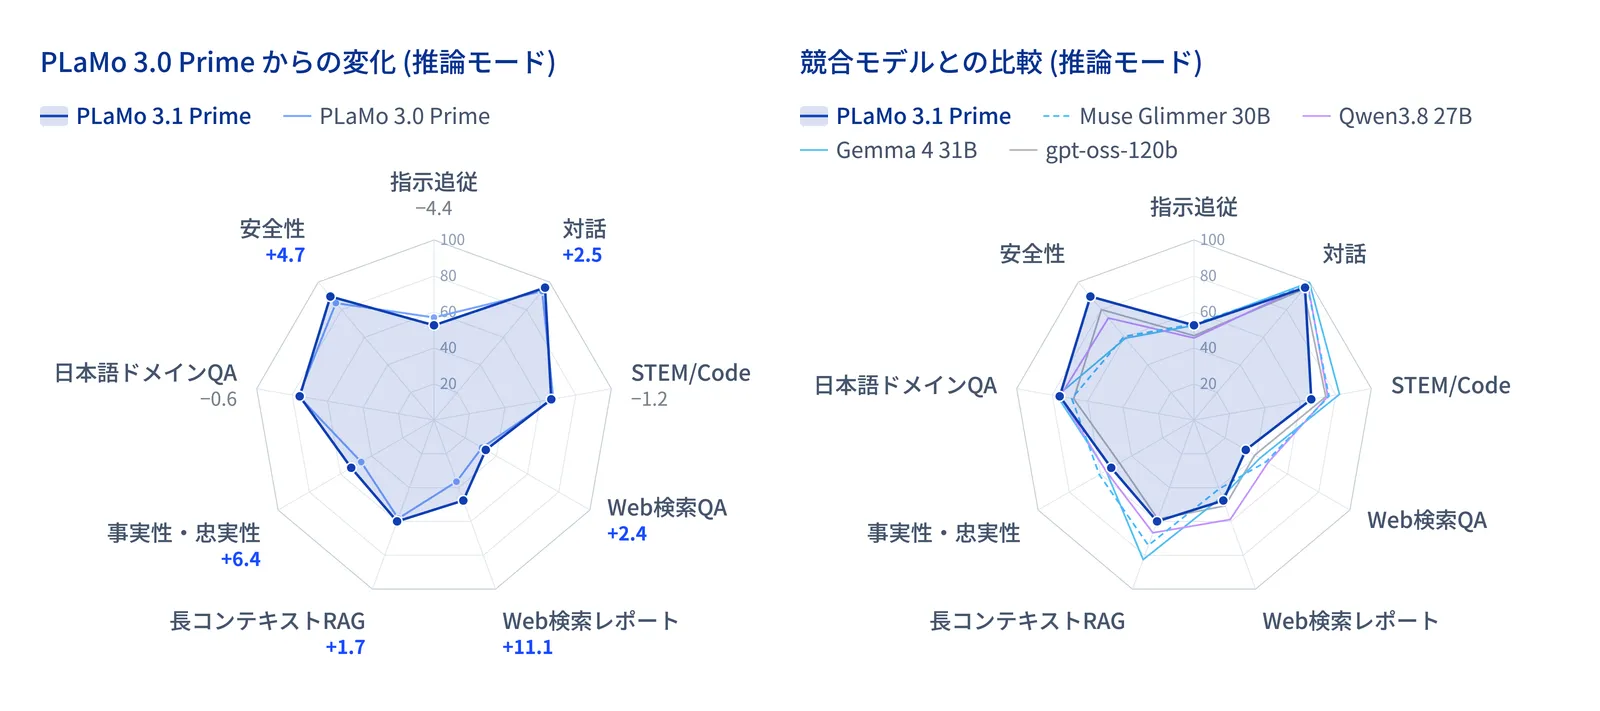
PFNは事後学習を見直し、知らないことを推測で埋めずに回答する事実性と、与えられた文脈に沿って答える忠実性を高めたと説明しています。Web検索と組み合わせ、調べても分からない内容には「分からない」と答えることを目指します。
PFNによると、8つのハルシネーション関連ベンチマークで、前世代のPLaMo 3.0 Primeに比べてスコアが平均約15%改善しました。
推論処理には投機的デコーディングを採用し、PLaMo 3.0 Prime比で1.7倍に高速化したとPFNは説明しています。この手法では、小さな補助モデルが次に続く文章の候補を複数作り、本体モデルが候補をまとめて検証することで、1語ずつ順番に生成する処理を減らします。候補が本体モデルに受け入れられる量や補助モデルの処理時間によって速度向上が変わるため、効果はモデル構成や処理条件に左右されます。
Chat、API、オンプレミスの3形態で提供
PLaMo 3.1 Primeは、PLaMo Chat、PLaMo API、オンプレミスの3形態で提供されます。APIのFreeプランは利用上限とレート制限付きで無料、Standardプランは100万トークンあたり入力60円、出力250円です。
PLaMo Chatでは、Deep Researchを1日2回まで無料で使える期間限定キャンペーンを11月30日まで実施します。APIのFreeプランでもキャンペーン期間中はWeb検索とDeep Researchを利用でき、検索は1日60回、月200回まで無料、Deep Researchは1日2回程度が目安です。
利用形態によって、データの扱いや運用条件は異なります。たとえばPFNは、PLaMo APIのStandardプランではChatと検索機能を除き、入出力プロンプトをモデル学習に使わず、入力データを保存しないとしています。オンプレミスでは顧客側の環境にモデルを導入して運用でき、企業向けの提供条件は個別見積もりです。