Baiduは10月27日、長文ドキュメント解析向けAIモデル「Unlimited OCR 2」をオープンウェイトで公開しました。OCR(画像中の文字を読み取る技術)を基盤とし、数百ページの文書を解析する際、文書が長くなるほど増える処理時間やメモリ使用量を抑える仕組みを備えています。
数百ページの文書を対象にしたモデル
文書解析では、文字の読み取りに加えて、表や図の認識、段落の順序や見出しの構造も扱います。複数ページにまたがる文章や表のつながりを保つことも、長文の処理における課題です。
Unlimited OCR 2は、最大300ページの文書でも高い解析精度を維持するとBaiduは説明しています。数十ページ規模のMPDocBenchと数百ページ規模のMarathonDocBenchの両方で、比較対象中の最高総合スコアを達成したとしています。
モデルのコードと重みはGitHub、Hugging Face、ModelScopeで無償公開されており、ライセンスはMITです。推論環境としてPyTorchとHugging Face Transformers、SGLangに対応し、サービス運用にはSGLangを推奨しています。
注意機構とページ分割で負荷を抑制
Transformerの推論では、KVキャッシュと呼ばれる領域に、過去のトークンから計算した注意機構用のキーと値を保存します。これにより、生成のたびに過去の状態を再計算する手間を減らせますが、文書のトークン数が増えるにつれてキャッシュも大きくなります。
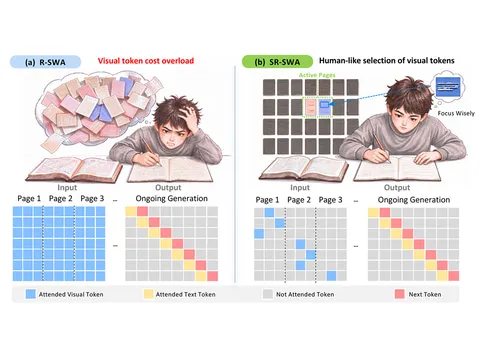
Unlimited OCR 2は、必要な文字や画像への注意機構の情報を一定サイズの参照セットに圧縮する「Sparse Reference Sliding Window Attention(SR-SWA)」を採用しました。文書の長さにかかわらず、デコードの各ステップにかかる時間とメモリ使用量をほぼ一定に保つとBaiduは説明しています。
さらに「Unlimited-Horizon Decoding」で文書を複数のページ群に分け、順番に処理します。隣り合うページ群の境界でKVキャッシュの一部を再利用し、不要な分を解放することで、ページ間の情報を保ちながらGPUメモリ消費を抑えます。
ベンチマークが測る長文解析の範囲
MarathonDocBenchは、100〜300ページの文書100件を対象とする長文解析ベンチマークです。約1万8,000ページ、約20万5,000件のレイアウト注釈を含み、中国語と英語の文書を扱います。
このベンチマークでは、ページをまたぐ文章や表が頻繁に登場します。文章や表の継続箇所に加え、要素の位置、種類、階層、読み順なども注釈され、長文の構造を評価できるよう設計されています。
MPDocBench-Parseは、15種類の文書を含む433件、計3,246ページのベンチマークです。英語と中国語の文書を扱い、文字・表・数式の認識に加えて、ページをまたぐ文章や表の結合、図の抽出、読み順、見出し階層などを評価します。
推論の使い方と公開された設定
Transformersでは、複数ページを一度のリクエストで処理する「infer_multi」と、1ページを動的に分割して解析する「infer」を利用できます。「infer_multi」はページ順に画像を渡し、文書内でページをまたぐ文脈を扱います。
Transformersでの動作確認環境は、NVIDIA A800-80GBとPython 3.10です。SGLangでは長文向けにページ群を分けて処理する設定例があり、1ウィンドウあたり10ページ、1ページあたりの出力上限は2万トークンです。
100ページ文書での速度比較では、デコードの各ステップがFull Attention比で7倍、R-SWA比で5.6倍高速になったとBaiduは報告しています。この比較は文書全体の処理時間ではなく、デコードのステップ単位です。
Hugging Face上のMarathonDocBenchのリーダーボードでは、Unlimited OCR Works 2の総合スコアは77.06です。総合スコアは8つの指標の平均で、文字、表、数式、読み順、図、見出しなどの解析結果を評価しています。