Recursiveは、ノートPCなどで動かせるコーディングモデル「Flint」を公開しました。開発には同社の自動研究システム「Eureka Machine」がほぼ全工程で使われ、チームは4カ月足らずでモデルを一から構築したといいます。Flintは、AIが次世代AIの開発を支援する取り組みを、実際のモデル開発に適用した例です。
40億ではなく400億パラメータのモデルをローカルで動作
Flintは、複数の専門ネットワークを使い分ける「Mixture-of-Experts(MoE)」方式を採用しています。モデル全体では400億パラメータを持ちますが、トークン(文章を処理する単位)ごとに使うのは25億パラメータです。この構成により、一般的なノートPCでも動作できるサイズになっています。
モデルの重みはHugging FaceでApache 2.0ライセンスのもと公開され、無料で利用できます。ローカル実行のため、オフラインで使えるほか、コードを外部サーバーへ送らずに扱え、クラウド型サービスの従量料金もかかりません。llama.cppやOllama、LM Studioなど複数の実行環境に対応し、RecursiveはFlint向けに最適化した推論エンジン「rec」も公開しました。
MoEでは、入力ごとに複数の専門ネットワークのうち一部を選んで処理するため、1トークン当たりの計算量を抑えられます。ただし、実行時に使うパラメータが一部でも、モデル全体の重みをメモリに置く必要があり、メモリ使用量は総パラメータ数の影響を受けます。消費者向け端末とエッジ端末で別のMoEモデルを測定した研究では、同じ有効パラメータ数の密なモデルより生成速度が遅くなる場合があり、端末のメモリや帯域幅が結果を左右しました。この研究の測定対象はFlintではなく、MoE方式だけで実機上の速度やメモリ効率が決まるわけではありません。
生成速度とコーディング評価
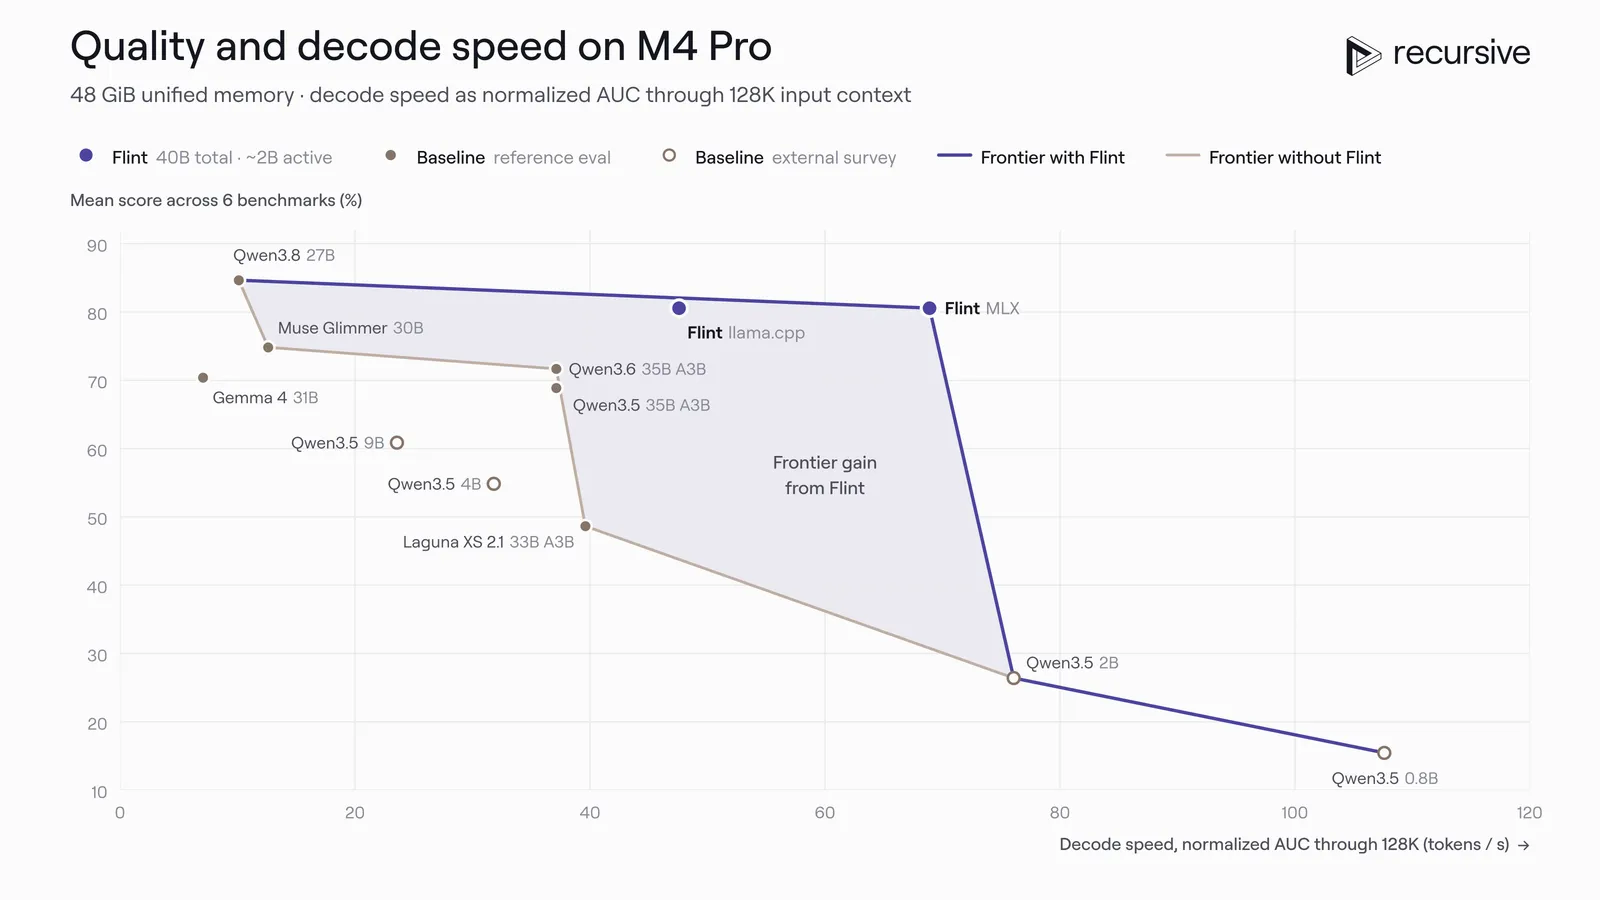
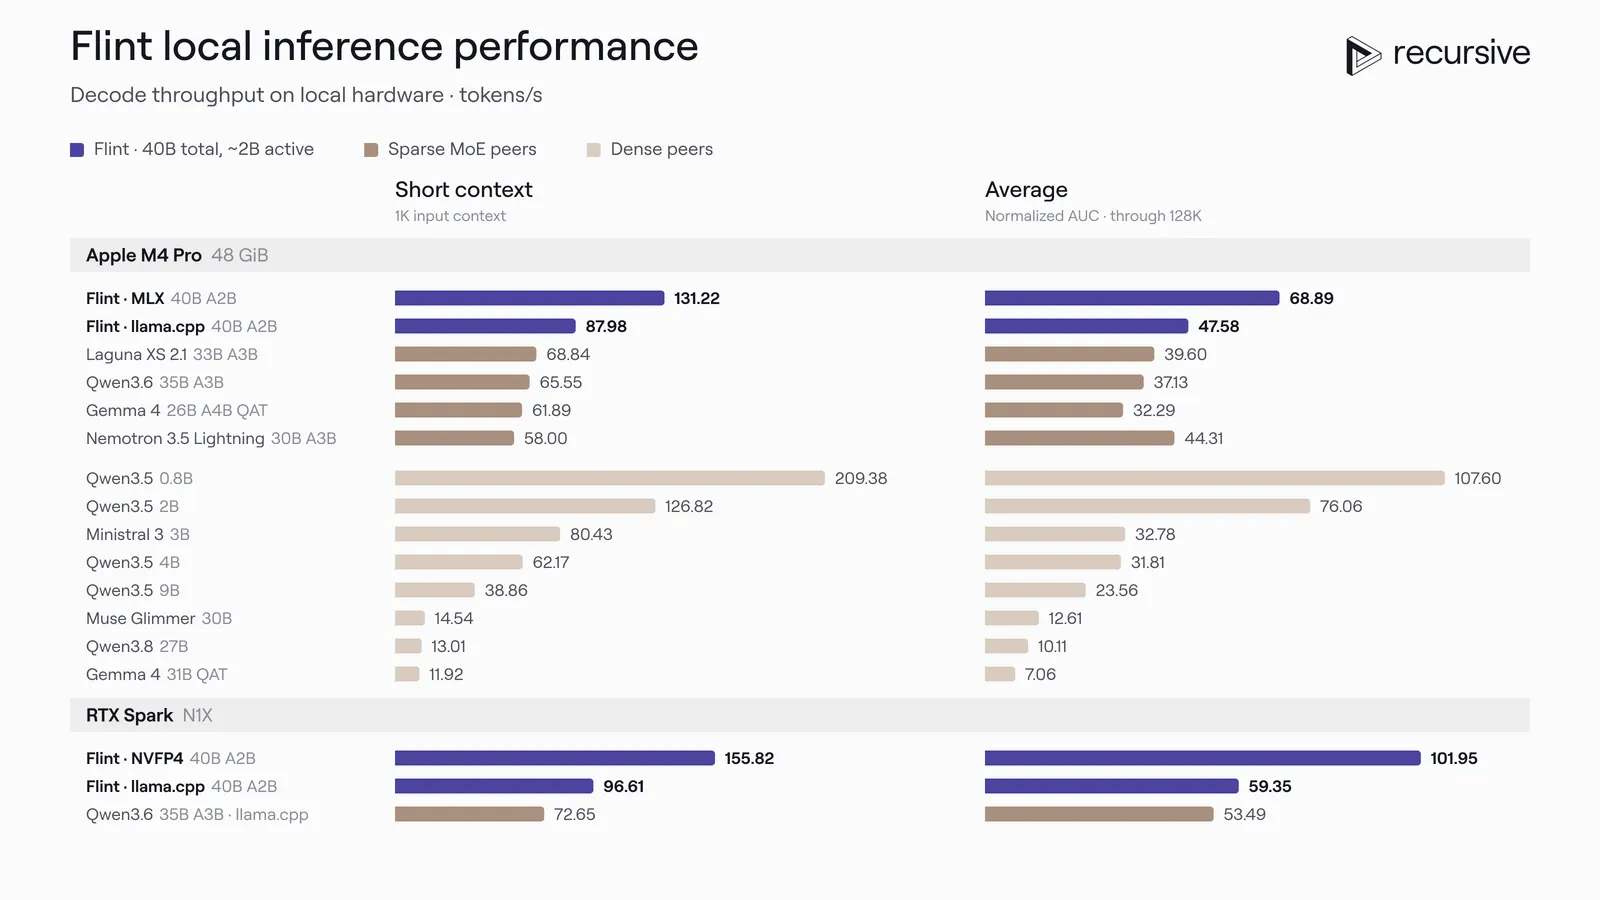
Recursiveの測定では、FlintはM4 Pro搭載MacBook Proで毎秒125トークン超、64GBのNVIDIA RTX Sparkで毎秒150トークン超を生成しました。短いコンテキストでの測定値で、同社は同クラスのモデルに対して最大2倍の速度としています。同社の別の測定では、M4 Pro搭載機で毎秒約131トークンを記録し、同じ機種で比較したモデルの毎秒58〜69トークンを上回りました。
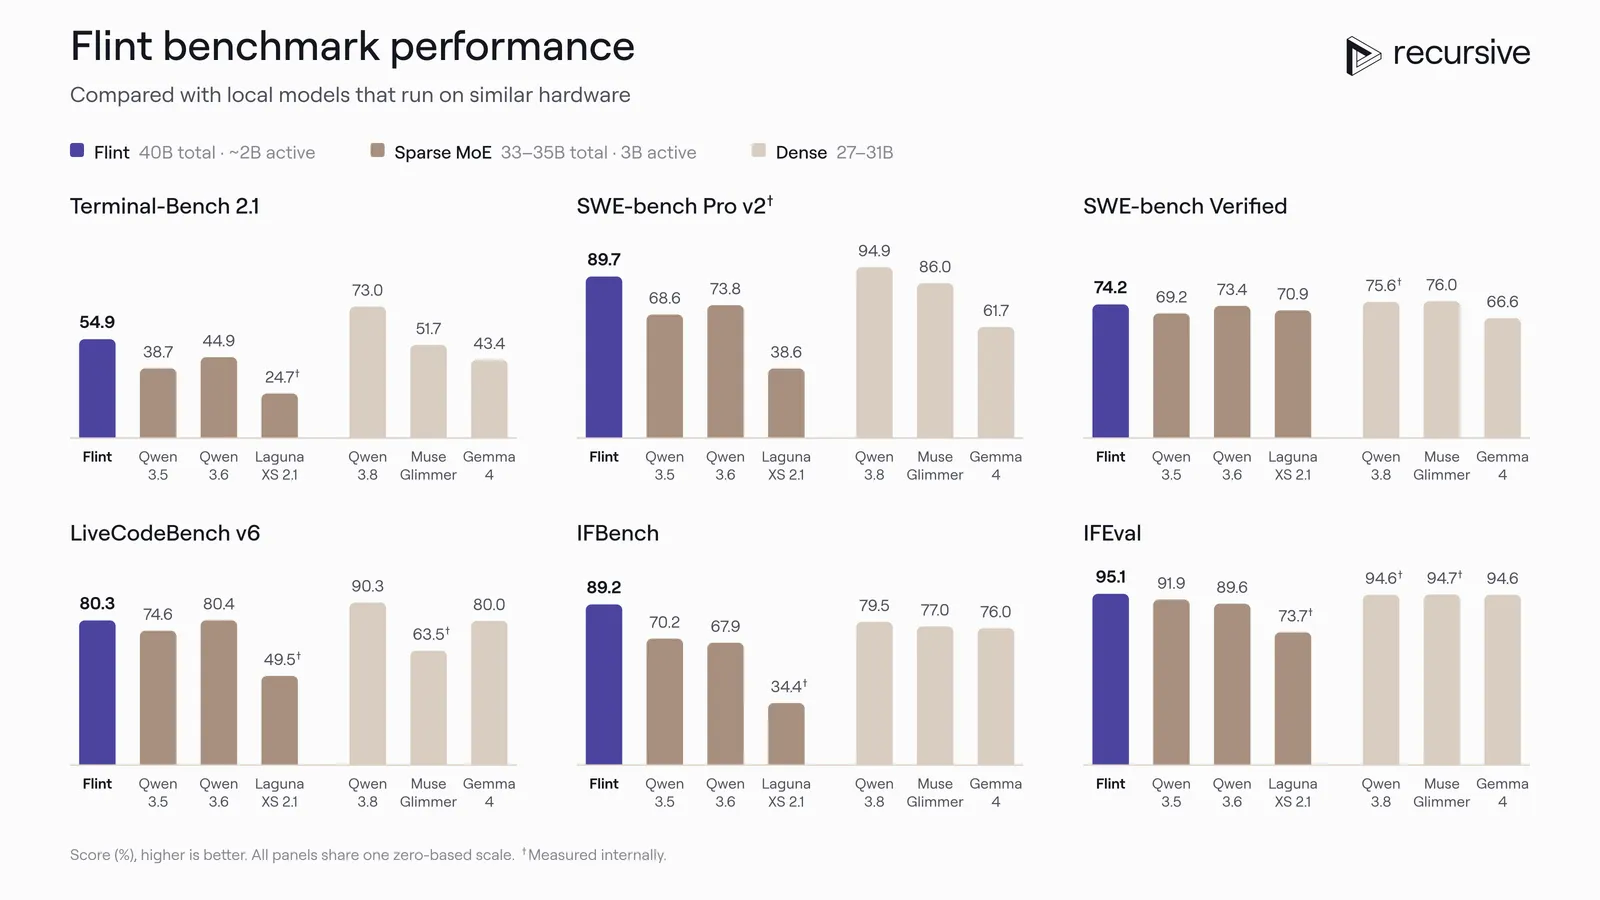
コーディング性能の評価には、実際のソフトウェア開発課題を使うSWE-Bench Verifiedなどが用いられています。Recursiveは、SWE-Bench Verified、SWE-Bench Pro v2、Terminal-Bench 2.1などの評価で、総パラメータ数が500億未満のMoEモデルの中でFlintが最良の成績だったとしています。
SWE-Bench Verifiedは、SWE-benchから人手で選別した500件の課題で構成され、問題文の明確さ、テストの妥当性、課題を解けることを注釈者が確認しています。言語モデル同士を比較する「Bash Only」評価では、全モデルにmini-SWE-agentと最小限のBash環境を用います。一方、公開ランキングには単純なモデル利用から検索拡張や複数回の試行を含むシステムまで異なる構成が含まれ、mini-SWE-agentのバージョンによって結果を単純比較できない場合もあります。Flintのスコアは、特定の課題群と実行条件での結果です。
Eureka Machineが担ったモデル開発
Eureka Machineは、研究案を出し、実装と実験を行い、その結果を次の試みに反映する自動研究システムです。Recursiveによると、Flintのデータ、学習方法、インフラ、推論の最適化にわたって開発を支援しました。同社は、モデル構造の探索、量子化の方法や専用カーネルの開発にも使ったとしています。
量子化は、モデルの重みをより少ないビット数で表し、メモリ使用量を抑える方法です。Recursiveは、出力層を4ビット化した後、16ビットモデルを教師として応答を学習させる工程を加え、最終的なNVFP4モデルの評価スコアを16ビット版から0.7ポイント以内に保ったと報告しています。また、同社はこの手法でFlintを71%小型化し、品質の低下をほぼ抑えたと説明しました。
自動研究の現状と人間の監督
RANDの分析では、AIはすでに研究開発の意味ある部分を自動化していますが、自ら研究課題を設定したり、後継モデルを設計したりするシステムは公に示されていません。同分析は、AIが研究課題の設定、新しい研究方式の創出、数週間にわたる作業を継続する能力も、まだ実証されていないとしています。そのため、研究開発の一部を自動化する現状と、AIが自ら改良を重ね続ける「再帰的自己改善」は区別されます。
RANDは、研究エージェントが計算資源の配分、学習の開始、評価方法の変更などを行う際、リスクに応じて人間の承認を求める枠組みを提案しました。Recursiveの長期目標は、Eureka Machineが人間の監督下で再帰的自己改善を達成することです。Richard Socher CEOは、問題が起きた場合に人間が工程を止められる形を想定していると語りました。同社は、生成モデルがEureka Machineの研究能力を高め、次のモデルをより速く作れるようになると見込んでいます。