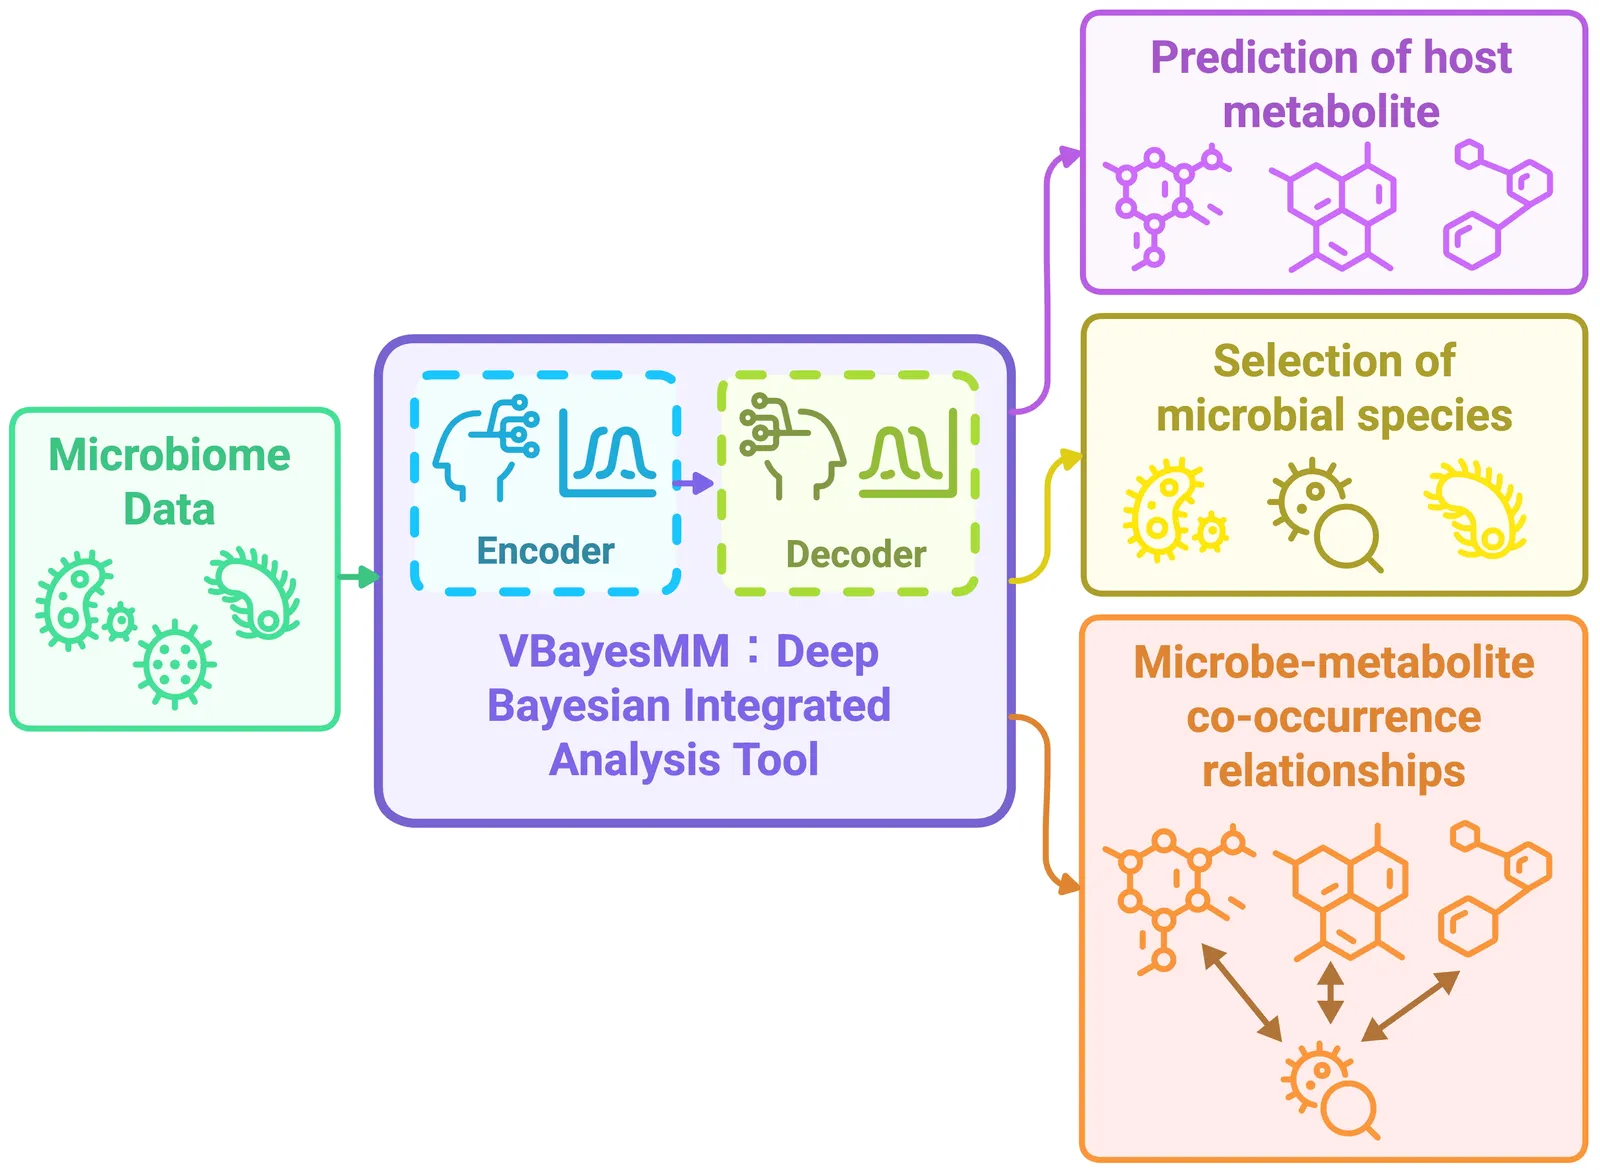
微生物の関係を組み込むMicroKPNN
腸内細菌の構成から疾患などの状態を予測する機械学習モデルに、微生物の代謝活動や系統関係、菌同士のコミュニティ構造を組み込む手法「MicroKPNN」が開発されました。炎症性腸疾患、2型糖尿病、肝硬変、大腸がん、肥満に関係する7つのデータセットで評価され、既存の全結合型ニューラルネットワークとDeepMicroを、いずれも7件すべてで上回りました。
MicroKPNNは、隠れ層が1層の浅いニューラルネットワークです。隠れ層には代謝物、分類群、微生物コミュニティを表すノードと、通常の全結合ノードを配置し、生物学的な関係をモデルの構造に反映します。
研究では、隠れノードの重要度スコアを使って、予測に関係する微生物要素を調べられるとしています。モデルの予測精度だけでなく、どの微生物の関係が予測に関わったかも検討できる設計です。
AUCは識別性能を測る指標
予測モデルの評価に使われるAUCは、陽性と陰性の対象をどの程度区別できるかを表す指標です。値は0.5から1の範囲で、高いほど識別性能が高いことを示します。
ただし、AUCの数値を「良好」「優秀」などと分類する基準には研究間でばらつきがあり、特定の値に付ける評価は一貫していません。予測値が実際の発生確率とどれだけ合うかを示す較正も、患者や医療者にリスクを伝える際に重要です。
臨床判断への有用性を評価するには、AUC以外の指標も必要です。意思決定の閾値や偽陽性・真陽性の影響を考慮する「ネットベネフィット」は、治療判断などの臨床状況に応じてモデルを使う価値を検討する指標です。
独立した集団での検証が必要
腸内細菌叢を使った分類研究102件を調べた系統的レビューでは、独立したテストデータによるAUCを報告していた研究は12%でした。残る88%の研究のAUCは、そのまま信頼できる値とはみなせないと分析されています。
テストデータがなければ、学習に使っていないデータでモデルを検証できません。また、テストデータの情報が特徴選択などを通じて学習過程に漏れると、実際より性能が高く見える可能性があります。
別の研究では、炎症性腸疾患の7つの研究データを組み合わせ、米国、アイルランド、ドイツ、イスラエル、中国の独立したデータでモデルを評価しました。地理的に多様なデータで学習しても、米国のデータだけで学習したモデルを上回るとは限らず、性能は評価対象の研究に左右されました。
この研究では、性能が近いモデル同士でも重要とされた菌種の重なりは小さく、共通して選ばれた菌種でも、患者と健常者のどちらに多いかが研究集団によって逆になる場合がありました。研究施設や集団が異なると、予測に使われる菌の特徴がそろわないことがあります。
地域差への対応策として、転移学習を使う手法も報告されています。転移学習は、ある地域で学んだ知識を別の地域の診断に生かす方法です。
この手法では、14都市から集めたデータを使い、7疾患について、都市内で学習・テストするモデル、別都市へそのまま適用するモデル、転移学習を加えるモデルを比較しました。都市をまたいでそのまま適用するモデルの平均性能は都市内モデルより低く、転移学習モデルでは性能が改善しました。
標準的なリスク情報との組み合わせ
フィンランドの住民コホートを追跡した研究では、遺伝的リスクスコア、腸内細菌データ、従来のリスク因子を、冠動脈疾患、2型糖尿病、アルツハイマー病、前立腺がんの発症予測で比較しました。追跡期間の中央値は17.8年で、電子健康記録を通じて新たな発症が調べられました。
腸内細菌のスコアは、年齢を基準にした予測に比べ、冠動脈疾患、2型糖尿病、前立腺がんで予測能力を高めました。一方、4疾患すべてで最も高い予測性能を示したのは、遺伝的リスクスコア、腸内細菌スコア、従来のリスク因子を統合したモデルでした。
肝線維症・肝硬変を対象にした別のメタ分析は、10研究の11試験、計838人を集計しました。腸内細菌データを使う機械学習モデルの統合AUCは0.86で、95%信頼区間は0.83〜0.89でした。
同じ分析で統合感度は0.81、特異度は0.85でした。研究者らは、臨床データが限られているため結果の解釈には注意が必要だとし、対象研究の多くでランダムフォレストが使われていた点も挙げています。