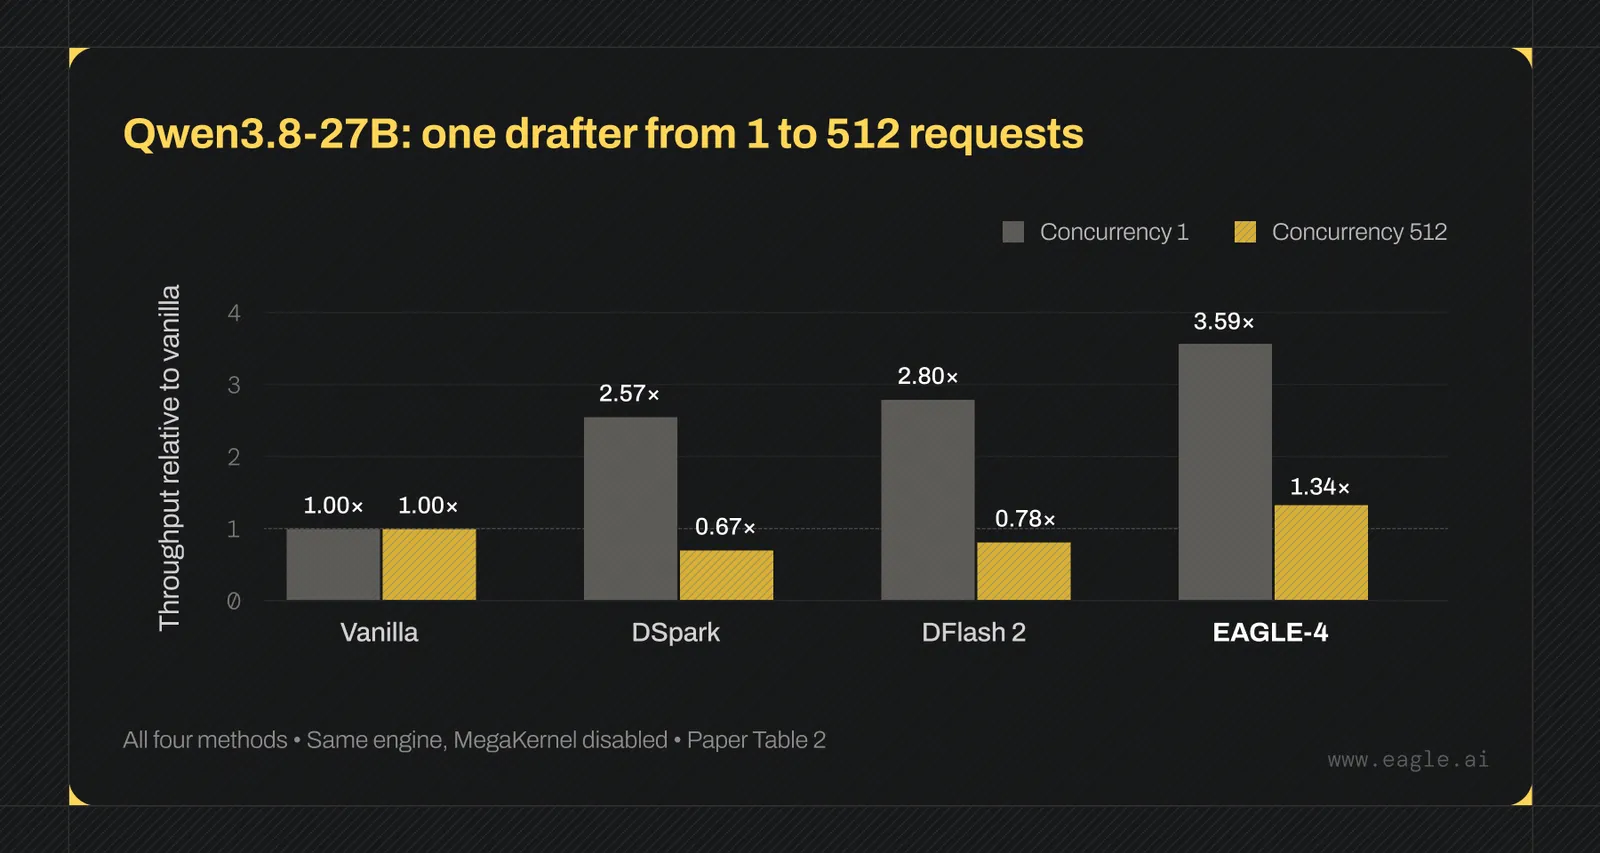
EAGLE-4のQwen3.8-27B向けドラフトモデルが公開されました。投機的デコーディングでは候補トークンを先に生成し、対象モデルで検証します。SPEED-Benchの単一リクエスト試験では、通常のデコードに対して最大3.59倍のスループットを記録しました。
Qwen3.8-27B向けドラフトモデルを公開
公開されたチェックポイントは、EAGLE-4の実装とQwen3.8-27Bを組み合わせるためのドラフトモデルです。単体で文章を生成するモデルではなく、対象モデルの推論を補助します。
投機的デコーディングでは、軽量なドラフトモデルが次のトークン候補を出し、大きな対象モデルが候補を検証します。候補をまとめて検証することで、対象モデルを逐次実行する回数を抑えて生成を進めます。
候補が棄却された場合は、対象モデルとドラフトモデルの確率分布の差に基づいて補正します。この検証と補正により、最終出力の確率分布を対象モデルのものに保ちます。
SPEED-Benchの単一リクエスト試験
公開された比較では、SPEED-Benchの定性的な分割を使い、Qwen3.8-27Bを4基のNVIDIA B300 GPUで動かしました。並列度は4、同時実行数は1、出力上限は4,096トークンです。各方式はMegaKernelを無効にした同一の推論エンジンで比較されました。
温度0ではEAGLE-4が毎秒863.8トークン、通常のデコードが240.5トークンで、速度比は3.59倍でした。温度1ではEAGLE-4が毎秒608.6トークン、通常のデコードが234.9トークンとなり、速度比は2.59倍です。
同じ測定の温度0では、DFlash 2が毎秒672.6トークン、DSparkが618.6トークン、MTPが534.5トークンでした。温度1ではそれぞれ560.3、519.4、369.1トークンを記録し、どちらの温度設定でもEAGLE-4が比較対象の中で最も高い値でした。
バッチや負荷に合わせる仕組み
EAGLE-4は、バッチサイズ、ハードウェア、ワークロードに応じて投機の進め方を変えるドラフト方式です。EAGLE-Harnessは実行時のドラフトと検証のコストを測り、環境に合う投機木の大きさを選びます。
EAGLE-4ではドラフトを1トークンずつ進めるため、各段階で候補の木を止めたり、深くしたり、広げたりできます。AMDによると、単一ユーザーでは幅や深さを広げ、負荷が高まると短いチェーンへ切り替えます。
ドラフト側の語彙候補の評価には、低ランクの候補ヘッドを使います。全語彙から候補を絞ってから通常のヘッドで厳密に採点する設計で、AMDは語彙を切り捨てずにドラフト処理のコストを40%超削減すると説明しています。ドラフトモデルはトランスフォーマー層1つで構成されます。
別のGPU構成でも測定
EAGLE-4の実装リポジトリでは、SGLangとvLLMを使ったQwen3.8-27Bの測定値も公開されています。4基のB300を使うSGLangでは、同時実行数8で通常デコードが毎秒1,479.4トークン、EAGLE-4が2,820.6トークンとなり、速度比は1.91倍でした。
同じSGLang構成の同時実行数64では、通常デコードが毎秒3,925.3トークン、EAGLE-4が5,281.3トークンで、速度比は1.35倍でした。4基のB300を使うvLLMでは、同時実行数1で毎秒241.6トークンから722.8トークンへ増え、速度比は2.99倍でした。
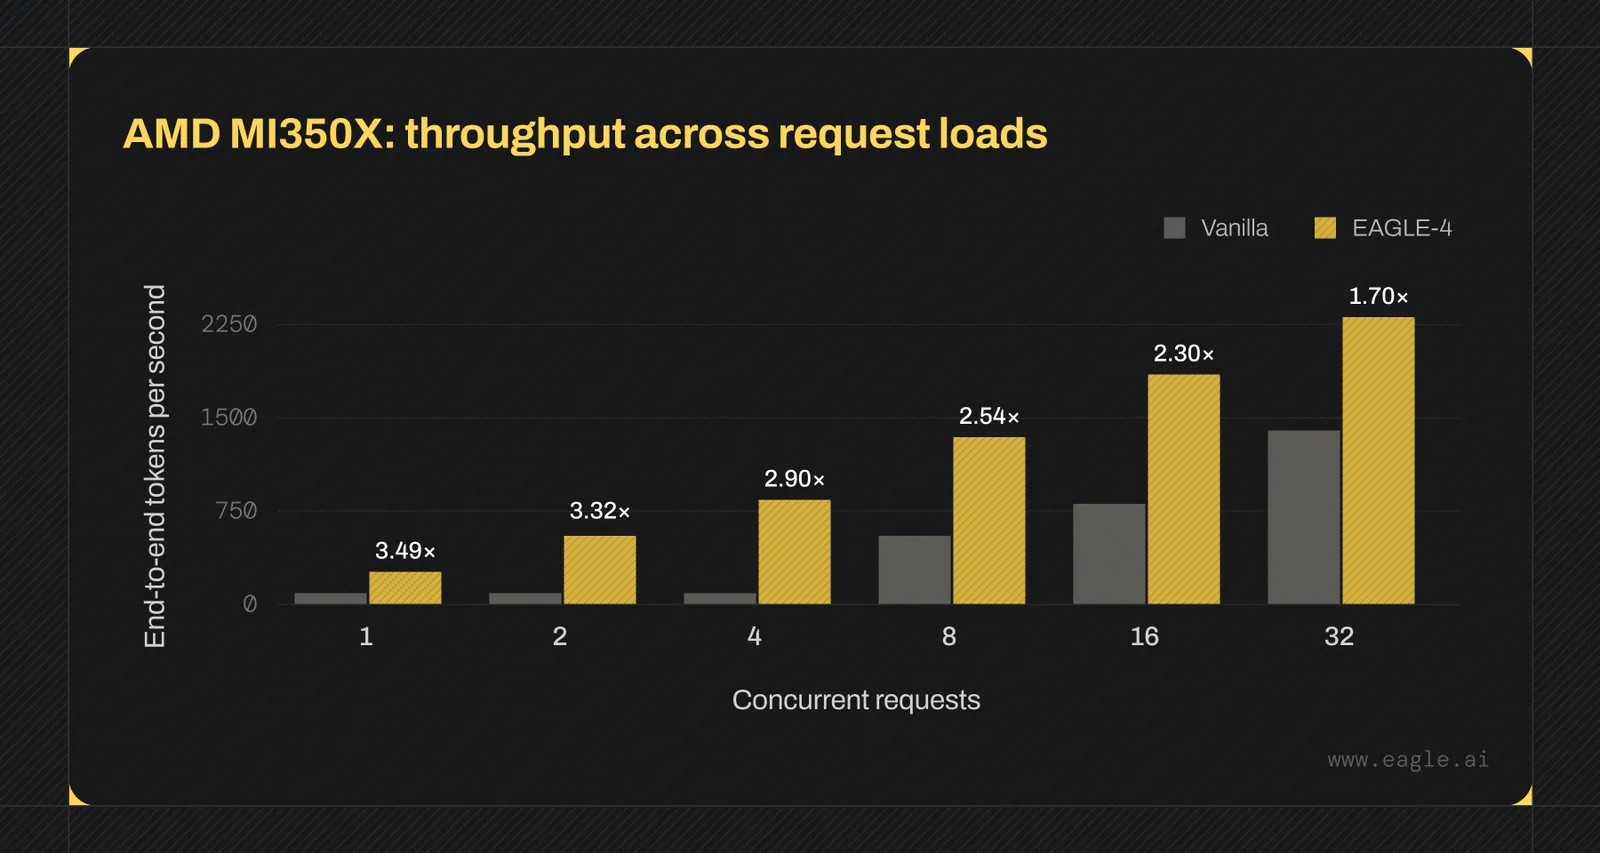
AMD Instinct MI355Xでも、Qwen3.8-27BをBF16で動かす測定が行われています。1基のMI355X、同時実行数1ではSGLangの通常デコードが毎秒82トークン、EAGLE-4が289トークンでした。同時実行数32では通常デコードが1,285トークン、EAGLE-4が2,784トークンでした。
同じ1基構成のATOMでは、同時実行数1でEAGLE-4が毎秒309トークン、同時実行数32で3,243トークンでした。4基のMI355Xを使うSGLangでは、同時実行数1で毎秒463トークン、同時実行数32で4,474トークンでした。