2B・4B・9Bを追加し、最小0.43GBに圧縮
PrismMLは、言語モデル「Ternary Bonsai 2」シリーズに、パラメータ数が20億、40億、90億の3モデルを追加しました。モデルの重みを「-1、0、+1」の3値で表すことで、元になったQwen3.5の各モデルより容量を9分の1以下に抑えています。
モデルサイズは2Bが0.43GB、4Bが0.95GB、9Bが2GBです。2026年9月に発表された27Bモデルと合わせ、シリーズは4サイズになりました。
新モデルはApache 2.0ライセンスで公開され、NVIDIA GPUではllama.cpp、AppleのMac、iPhone、iPadではMLXを通じて動作します。PrismMLは、PCやスマートフォン、ウェアラブル機器で動くローカルAIエージェントの構築を想定しています。
3値化で重みの保存量と計算を抑える
量子化は、モデルの重みをより少ない情報で表現する方法です。Ternary Weight Networksに関する研究では、重みを-1、0、+1に制限し、元の浮動小数点の重みに近づけるための倍率を組み合わせます。
同研究の方式では、重み1つの保存に2ビットを使い、32ビット浮動小数点の重みと比べて、モデルを最大16分の1に圧縮できるとしています。3値化一般ではこの圧縮率が説明されています。Bonsai 2の各モデルサイズはPrismMLが公表した値です。
推論時の計算では、重みとの積を求める演算を、入力値の加算を中心とした演算に置き換えられます。重みが0の項は加算に含めません。この演算で、重みの保存量や計算負荷を抑えます。
ベンチマークでは分野ごとに差
PrismMLは、エージェント・ツール呼び出し、数学、指示追従、コーディング、知識・推論、画像理解の6分野、計19種類のベンチマークで、各サイズを対応するQwen3.5と比較しました。
元モデルに対するスコアの割合は、3モデルとも数学で98.2%以上、指示追従で100%以上、コーディングで100.1%以上でした。一方、知識・推論は82.9〜93.0%、画像理解は89〜92.5%で、分野によって差があります。
知識・推論の評価に使われたGPQA Diamondは、物理、生物、化学の大学院レベルの問題からなるGPQAのうち、難度の高い198問を扱うベンチマークです。GPQAの問題は各分野の専門家が作成した選択式で、元の研究では448問が収録されています。2BのGPQA Diamondスコアは39.6で、対応するQwen3.5 2Bの58.48に対する割合は67.7%でした。
端末での速度とモデルの使い分け
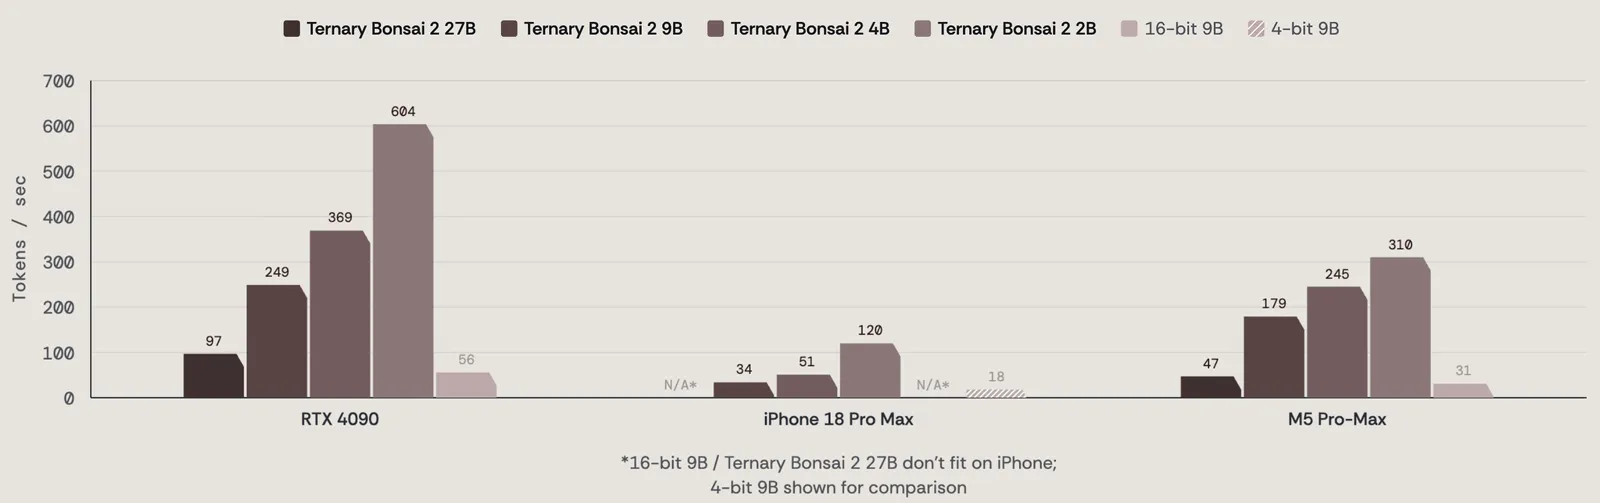
PrismMLは、GeForce RTX 4090やM5 Proで、フル精度の対応モデルと比べて最大5倍のスループットと3倍の電力効率を達成したとしています。M5 Max Proでの最大スループットは、9Bが毎秒179トークン、2Bが毎秒310トークンです。
iPhone 18 Pro Maxでは、9Bが毎秒34トークン、2Bが毎秒120トークンに達するとPrismMLは報告しています。
開発では、同じ出力を繰り返さないこと、指示への追従、モバイルでのツール呼び出し、冗長な出力の抑制を重視したとPrismMLは説明しています。9Bは標準的な指示追従と日常的な数学タスクで、消費トークン数を約40%削減したとしています。