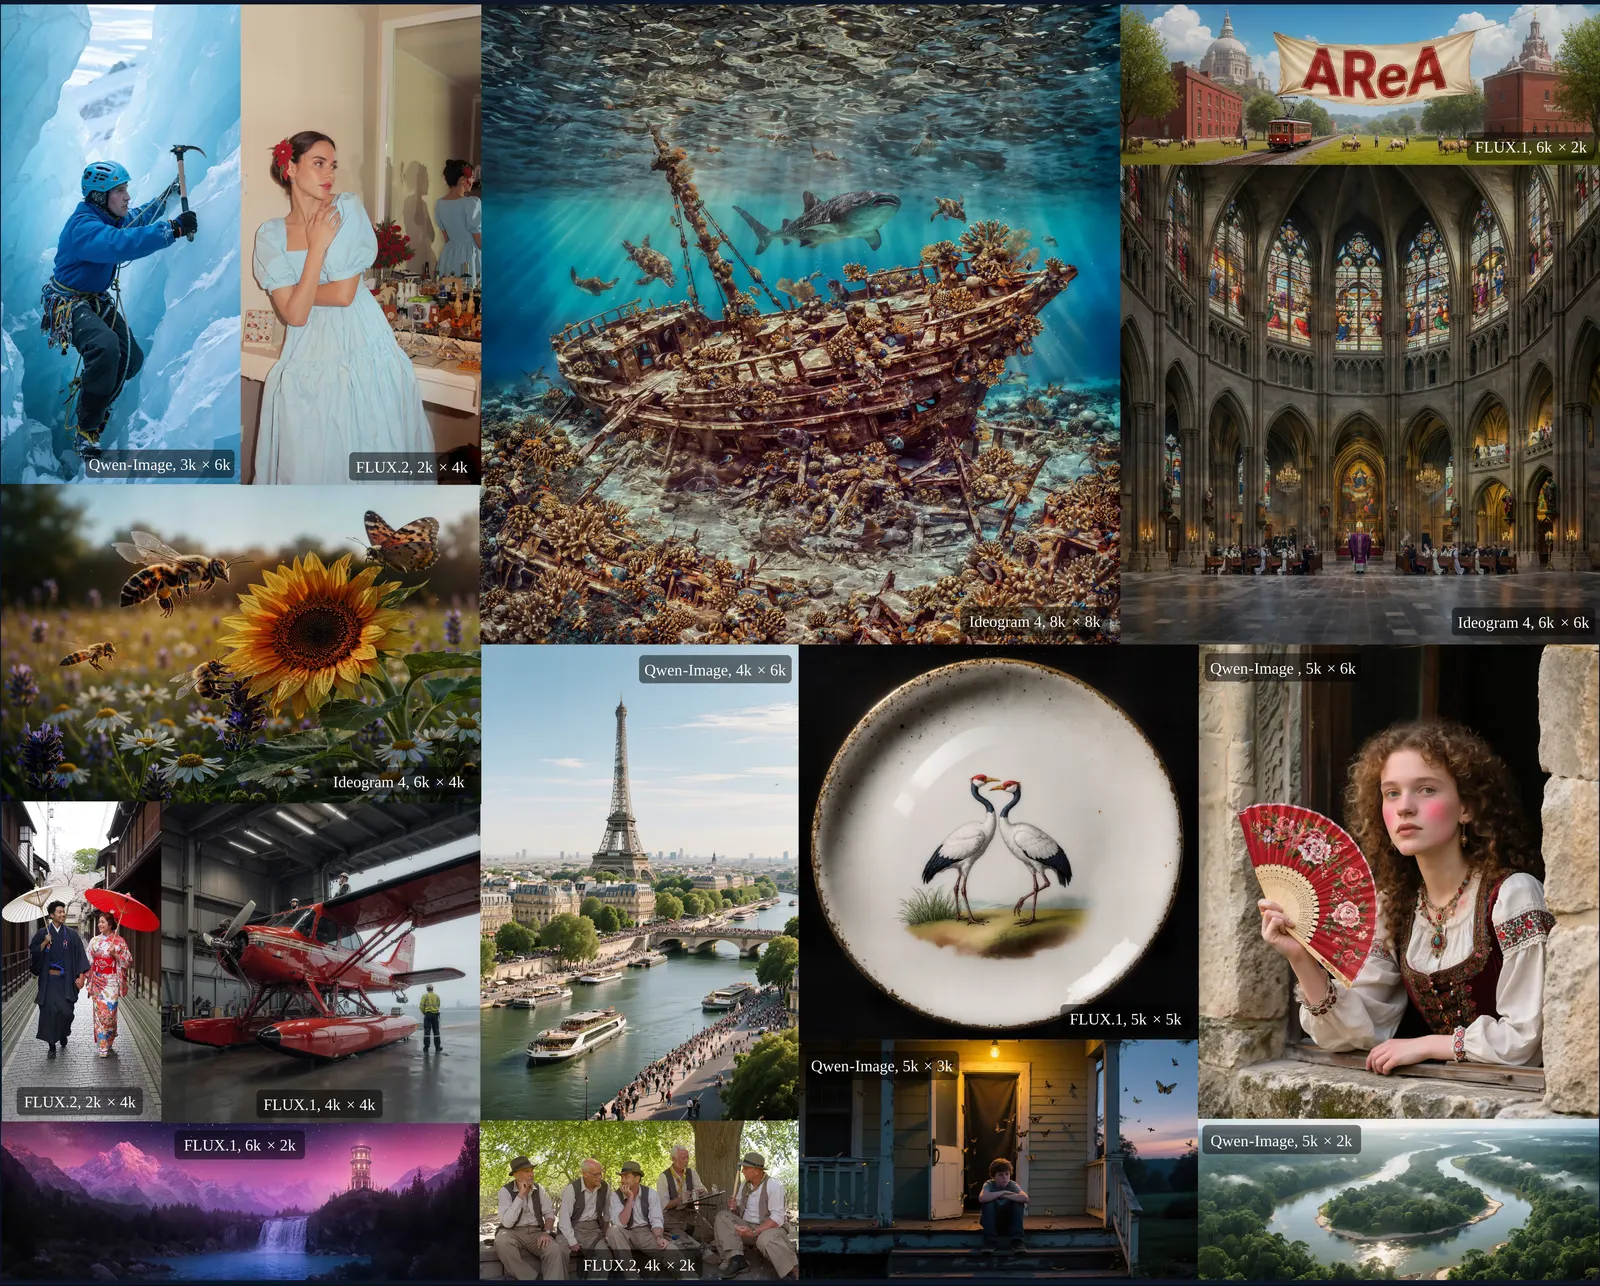
拡散Transformerで学習時より大きな画像を生成すると、注意計算の負荷が増える一方で、構図や細部が崩れることがあります。AReAは生成の進行に合わせて注意の範囲を全体から局所へ移し、追加学習なしでこの課題に対処する手法です。
高解像度化で注意計算と構図が課題に
拡散Transformerは、ノイズから画像を段階的に生成するモデルです。自己注意は画像内のトークン同士の関係を扱いますが、全トークンを毎回比較する計算量はトークン数に対して二次的に増えます。解像度が上がるほど、計算負荷も大きくなります。
学習時より多くのトークンや、より離れた位置関係を扱うことも、生成結果に影響します。全体に一律の注意を適用すると、計算コストが増えるうえ、モデルが学習時の範囲を超える位置関係を扱うため、構造の歪みや細部の劣化につながります。
AReAは、生成の早い段階で画像全体の構図を整え、後半で局所的な細部を調整するという、注意範囲の変化に着目しました。全工程で同じ範囲を参照せず、段階ごとに注意の仕組みを切り替えます。
前半は全体を見渡し、後半は細部に集中
前半の「粗い注意」では、各トークンの問い合わせ側は高解像度のまま保ち、参照するキーと値をブロック単位にまとめます。画像全体を参照できる状態を維持しながら、各問い合わせが扱うキーの数を減らして計算を軽くします。
ブロックの大きさは前半の進行に合わせて小さくなり、参照情報が段階的に細かくなります。また、位置関係を扱うRoPE(回転位置埋め込み)に合わせ、まとめたキーの座標と問い合わせ座標を調整します。AReAは、RoPEを学習範囲の外へ外挿せずに動作する設計です。
後半の「適応型ウィンドウ注意」では、画像を局所領域に分け、領域を参照する窓を段階的に縮めます。滑らかな領域の窓はさらに分割し、細部の多い領域では大きさを保ちます。隣接領域のトークンを加える仕組みや、画像全体から特徴的なトークンを各窓へ共有する仕組みも組み合わせます。
DyPEとは異なる位置情報へのアプローチ
DyPEも、拡散Transformerの高解像度生成を追加学習なしで扱う手法です。生成の進行に伴う周波数成分の変化に合わせ、各ステップで位置埋め込みを調整します。低周波の構造が先に定まり、高周波の細部が後から形成される過程を利用します。
DyPEの論文は、FLUXで1,600万画素を超える画像の生成を例に挙げ、追加のサンプリングコストなしで高解像度化できるとしています。AReAは位置埋め込みの周波数調整ではなく、キーと値の集約や局所ウィンドウによって注意の範囲と計算量を変える方式です。
両手法は生成工程に応じて処理を変える点では共通しますが、変更する対象が異なります。AReAは全解像度での全注意計算を行わず、前半の全体参照と後半の局所参照を組み合わせます。DyPEは位置埋め込みを動的に調整する設計で、AReAは注意計算そのものを段階化します。
FLUX.1のベンチマークと公開コード
AReAの評価では、FLUX.1を使った6,144×6,144ピクセルの生成で、全注意計算に対して3.2倍の高速化が示されました。Qwen-Imageでは同じ解像度で2.9倍と報告されています。
4K画像のベンチマークでは、FLUX.1のAReAを比較対象の学習不要手法と並べて評価し、画像品質やプロンプトとの一致度など複数の指標を掲載しています。たとえば表にあるAReAの値は、ImageRewardが1.3250、Aestheticが6.37、CLIPが29.71、PickScoreが23.31です。
公開コードはFLUX.1に対応し、生成用のプロンプト集HRGen-1Kも公開されています。リポジトリではQwen-Image、FLUX.2、Ideogram 4を今後対応するモデルとして挙げています。AReAはモデルの注意処理へ組み込む構成で、FLUX.1ではDiffusersのパイプラインに適用する手順が示されています。