Appleは、社内で使われていないMacのGPUを集め、AIの推論タスクを分散実行するシステム「Minions」を運用しています。集中型GPUの空き待ちが10時間を超える場合もあった処理を、空きリソースの活用によって数分で始められることがあります。Thunderbolt 5のRDMAクラスタが複数Macの計算資源やメモリーをまとめて大きなモデルを扱う構成なのに対し、Minionsはネットワーク上の空きGPUへタスクを振り分けます。
Minionsは空きGPUを推論タスクに割り当てる
Minionsは、macOSデバイスのアイドル状態にあるApple Silicon GPUを集約し、機械学習の推論処理を実行する分散基盤です。既存の機器を活用することで、チームはGPUを追加購入せずに推論用の計算資源を利用できます。
システムは、依頼を受け付けて小さなタスクに分けるMinion Server、GPUで推論を実行するMinion Executor、タスク情報を管理するPostgreSQLのデータベースで構成されます。Executorは処理結果をS3に送り、実行状況をServerへ報告します。
Minion WatchdogはMacが応答しないなどの障害を監視し、必要に応じてタスクを再割り当てします。タスクの状況はデータベースに記録され、Grafanaのダッシュボードで確認できます。Appleは、中央のGPU資源が限られる環境で、待ち時間の短縮と既存機器の活用につながったとしています。
RDMAクラスタは複数Macのメモリーを使う
RDMAは、別の計算機のメモリーへ直接アクセスする通信方式です。Thunderbolt 5を使うMacのクラスタでは、複数台のメモリーを合わせ、単体のMacには収まらないモデルを実行できます。
この方式では、モデルの層を複数のMacに分けて順番に処理するパイプライン並列化や、各層の計算を分担するテンソル並列化が使われます。パイプライン並列化では単体に収まらないモデルを扱えますが、1件の処理の生成速度を上げる方法ではありません。複数の依頼を並行して処理すると、全体の処理量を伸ばせます。
テンソル並列化では各Macが同じ層の計算に参加するため、ノード間での高速な通信が重要です。RDMAを使うテンソル並列化は低遅延の接続を必要とし、通信のやり取りが増えます。
ベンチマークではRDMA対応の構成が伸びた
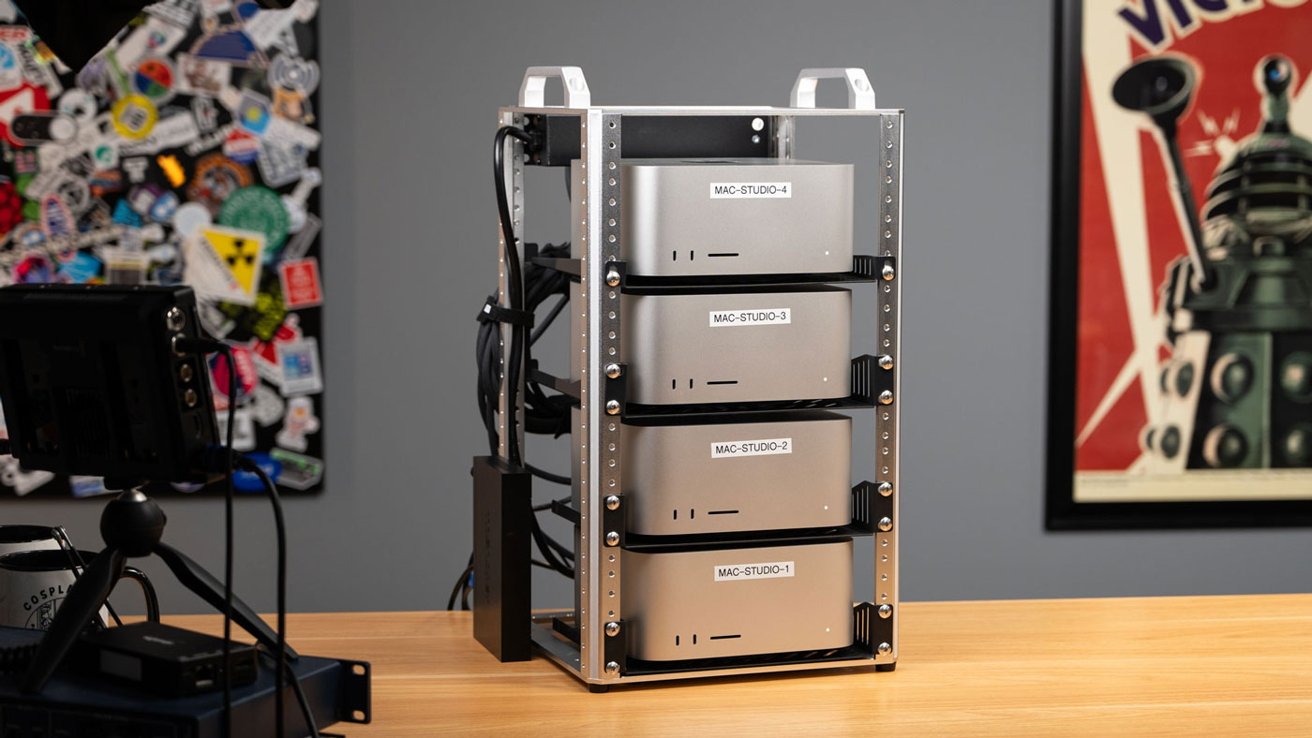
4台のMac Studioによる試験では、Qwen3 235Bの処理で、RDMA対応のExoは1台構成の毎秒19.5トークンから、4台構成で毎秒31.9トークンへ伸びました。Exoはこの試験でRDMAを利用し、比較対象のLlama.cppは利用していません。
同じQwen3の試験で、Llama.cppは1台構成の毎秒20.4トークンから、4台構成では毎秒15.2トークンへ下がりました。ノードを増やせば常に処理が速くなるわけではなく、分散方式とノード間通信の対応が結果に関わります。
モデルが1台に収まり、単一の依頼を対話的に処理する場合、クラスタ化によって速度が下がることもあります。一方、モデル容量が単体の上限を超える場合や、複数の依頼をまとめて処理する場合は、分散する理由があります。