DeepSWE v1.1で77.0
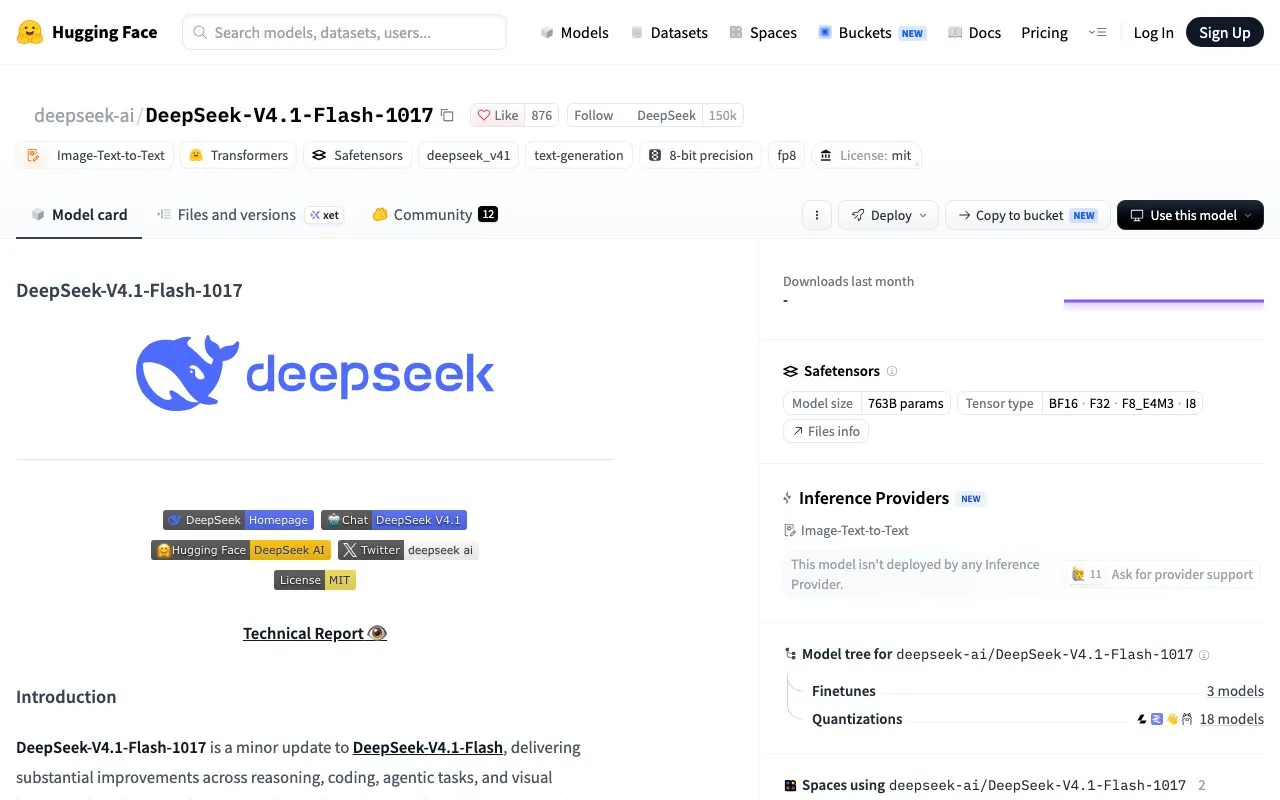
DeepSeekは10月17日、生成AIモデル「DeepSeek-V4.1-Flash-1017」を発表し、同日、MITライセンスで重みを公開しました。コード修正ベンチマーク「DeepSWE v1.1」では77.0を記録し、DeepSeekが公表した比較表でClaude Opus 5の74.0を上回りました。
同じ比較表では、業務自動化を測るAutomation-Bench v1.0.6が60.5対50.3、実務タスクを扱うAgents' Last Examが35.4対28.6、Apex Bench v1.1が72.1対65.8で、いずれもOpus 5を上回りました。一方、端末操作を伴うコーディングのTerminal-Bench 4.0は42.3で、Opus 5の51.8を下回りました。
前のバージョンと比べると、Terminal-Bench 4.0は31.2から42.3、DeepSWE v1.1は74.2から77.0へ上昇しました。難問試験HLEは前のバージョンの36.8から42.6へ伸びましたが、Opus 5の56.3には届いていません。ベンチマークごとに順位が異なり、すべての課題で優位という結果ではありません。
552BのMoEと条件付きメモリ
モデル本体は総パラメータ数552B(5,520億)のMoE型です。MoEは複数の専門ネットワークから入力に応じて必要な部分を動かす構成で、入力を読む段階では8B、出力生成では16Bのアクティブパラメータが動きます。
本体とは別に、条件付きメモリ「Engram」が196Bあります。これは参照表のように、処理中の語に応じた行を読み出す仕組みで、表全体が常時動くわけではありません。Hugging Face上の重みの合計は約763Bで、その差分の大部分は推論を速める投機デコード用モジュール「DSpark」の約14Bです。
投機デコードでは、小さなドラフトモデルが複数の候補トークンを作り、対象モデルが候補を検証します。対象モデルは一致した候補をまとめて受け入れるため、通常の逐次生成より多くのトークンを一度に処理できる場合があります。研究では、速度向上はドラフトモデルの遅延や受け入れられるトークン数に左右される一方、検証を通じて出力品質を保つ方法として説明されています。DeepSeekはDSparkを推論高速化用として挙げていますが、このモデルでの速度や計算コストの具体的な改善量は公表していません。
公開形態と利用条件
オープンウェイト版はHugging FaceとModelScopeで公開され、ライセンスはMITです。商用利用、改変、再配布が認められています。モデルはテキストと画像を入力でき、コンテキスト長は100万トークンです。
DeepSeekはWebサイト、アプリ、APIにも新モデルを投入しました。また、Web検索とページ取得を行うSearch APIとFetch APIを全ユーザー向けに開放し、各APIの料金を1,000回あたり0.75ドル(約120円)としています。
利用時の推奨値はtemperature 1.0、top_p 1.0で、最大出力には25万6,000トークン以上を確保するよう推奨されています。Transformers、vLLM、SGLangなどを使った実行手順も公開されています。ローカル実行には重みを扱う環境が必要です。
DeepSWE v1.1が測るコード修正能力
DeepSWEは、長い工程を要するソフトウェア開発タスクを対象にしたベンチマークです。v1.1はv1と同じ113件の課題を使い、実行・採点方法を更新しています。課題は公開リポジトリから集めた修正ではなく、91の活動中のリポジトリと5言語を対象に独自に作成されました。
v1.1では、エージェントがコミットしたコード差分を取り出し、作業環境から切り離した新しい環境で適用して検証します。各課題には要求された機能を確かめる検証器があり、特定の実装方法ではなく、動作要件を満たすかどうかを採点します。テスト結果も構造化され、課題を定義するテストごとの合否を記録する方式になりました。
DeepSWEのpass@1は、全課題を等しい重みで扱った平均合格率です。したがって77.0は、同ベンチマークのコード修正課題に対する合格率を示します。比較ではモデルの設定と実行環境をそろえています。スコアは比較対象と課題範囲に基づきます。