SpaceXが、NVIDIA製AIプロセッサーの購入に向けて400億ドル(約6兆円)の資金調達を検討していると報じられました。案では銀行融資と投資適格債を組み合わせ、2027年の成立を見込んでいます。協議は初期段階で、実現は確定していません。調達額は、購入対象とされるVera Rubin世代のラック構成や、AIインフラ投資で広がる資金調達方式とあわせて報じられています。
銀行融資と投資適格債を組み合わせる案
Tom's HardwareがFinancial TimesとBloombergの報道をもとに伝えた案では、SpaceXは銀行から100億ドルを借り入れ、投資適格債市場で300億ドルを調達する計画です。投資適格債は、信用力が比較的高いと評価された発行体の債券です。Apollo Global Managementが取りまとめを主導する見通しで、債券運用会社のPIMCOなども参加を協議しているとされています。
この資金はNVIDIAのAIアクセラレーター購入に充てられると報じられました。Tom's Hardwareは、xAIがこれまでNVIDIAやそのパートナーからサーバーやラック規模のシステムを調達してきた経緯を挙げ、今回も完成したシステムを購入する可能性を伝えています。調達の成立や最終的な購入内容は決まっていません。
同社のAI計算基盤はすでに大規模です。イーロン・マスク氏は、Colossus 2にNVIDIAのGB200アクセラレーター11万基とGB300を44万基搭載していると述べたと報じられています。今回の調達案は、既存設備に次世代の計算能力を加える構想として伝えられています。
AIデータセンターで広がる資金調達の仕組み
Joe Toppe氏は、AIデータセンター開発の資金調達方式として、特別目的会社(SPV)が施設を保有し、利用企業が長期契約を結ぶ仕組みを紹介しています。同氏によると、利用企業の信用力や契約収入の見通しが、SPVの債券を投資適格と評価する際の支えになります。この一般的な市場構造が、SpaceXの今回の案に採用されるという意味ではありません。
Joe Toppe氏はまた、SPVが建設資金を調達し、施設の稼働後にリース収入などを裏付けとする長期資金へ借り換える方式を挙げています。同氏によると、保険会社、年金基金、インフラファンドなどが、こうした債券や融資の最終的な保有先になり得ます。SpaceXの案は銀行借入と投資適格債を組み合わせるとされていますが、SPVを介する方式とは異なります。
Mainstreet Macroは別の事例として、ApolloがValor Compute Infrastructureを通じ、xAI子会社向けにNVIDIAのGB200を調達・供給するリース型の資金調達を主導したと記しています。同媒体の分析では、この方式の融資判断はGPUだけでなく、顧客との長期契約にも基づきます。また、同媒体はGPUが次世代製品の登場で価値を失う可能性を、担保に依存する融資のリスクとして指摘しています。今回の調達案にもApolloが関与すると報じられていますが、取引の構造や規模が同じとは限りません。
Vera Rubin NVL72はラック内に72基のGPUを集約
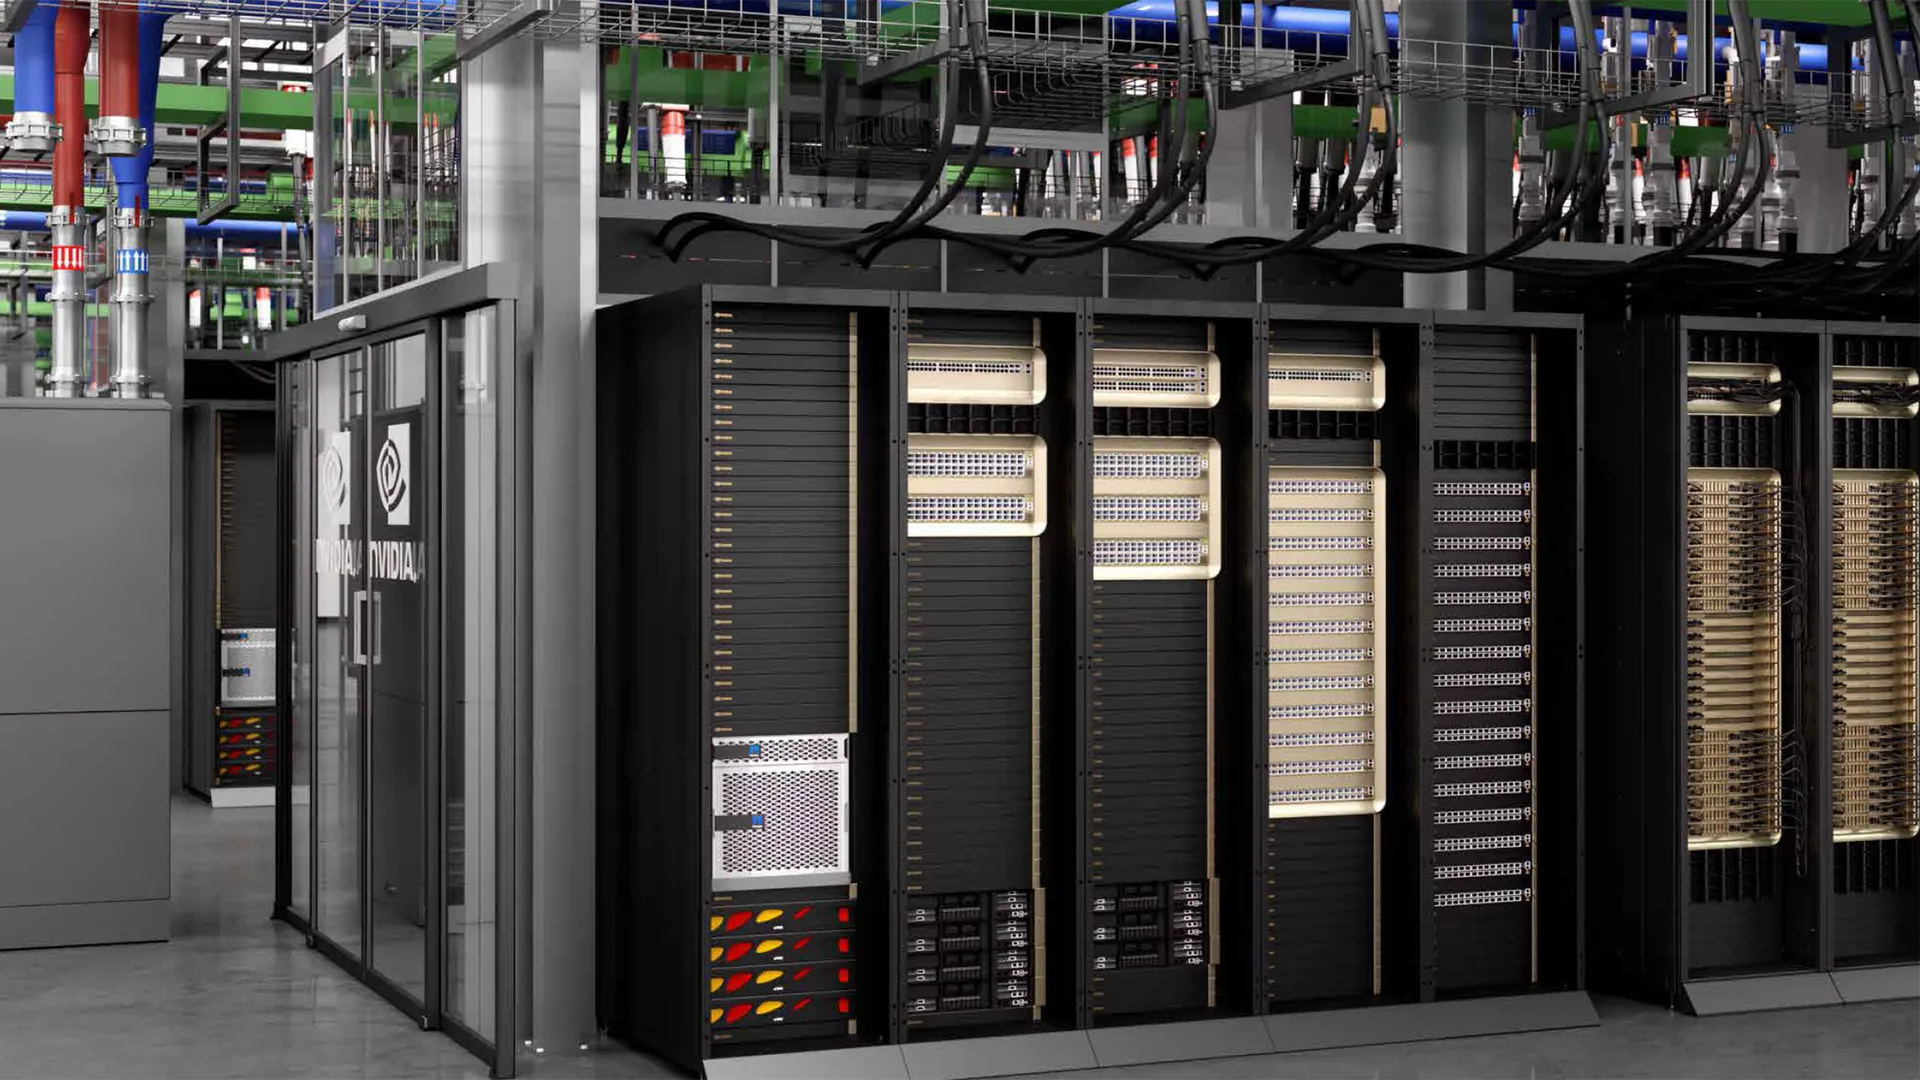
Ciscoが扱うVera Rubin NVL72は、NVIDIAのRubin GPU 72基とVera CPU 36基を1つのラックに組み込む構成です。ラック内部は18基の計算トレイ、9基のNVLinkスイッチトレイ、4基の電源シェルフで構成され、Supermicroがハードウェアを製造・統合するとされています。Ciscoはラック単位でシステムを販売し、CiscoとSupermicroがサポートを担う構成です。
各計算トレイにはRubin GPUが4基、Vera CPUが2基搭載されます。NVLink 6はラック内のGPU同士を接続するインターコネクト技術です。Ciscoの仕様では、帯域幅はGPU当たり毎秒3.6テラバイト、ラック全体で毎秒260テラバイトです。この接続により、ラック内の72基を一つの計算システムとして構成します。
ラックの高速メモリーは、GPU側のHBM4が20.7テラバイト、CPU側のLPDDR5Xが54テラバイトで、合計約75テラバイトです。GIGABYTEの仕様も、72基のGPUと36基のCPU、HBM4 20.7テラバイト、LPDDR5X 54テラバイトという構成です。同社はこれらをラック単位のAI計算システムとして紹介しています。
Blackwellとの比較で示された性能とコスト
NVIDIAは、Rubin GPU 1基当たりのHBM4帯域幅を毎秒22テラバイトとし、Blackwell世代の毎秒8テラバイトに対して2.8倍になると説明しています。また、NVLink 6のGPU当たり帯域幅は毎秒3.6テラバイトで、BlackwellのNVLink 5に対して2倍としています。NVIDIAは、Blackwellと比べて大規模モデルの学習に必要なGPU数を4分の1に、推論のトークン当たりコストを10分の1にできると主張しています。
TechTimesが紹介したNVIDIAの説明によると、ラック全体のメモリー帯域幅は毎秒1.6ペタバイトで、BlackwellベースのGB200 NVL72に対して約2.8倍です。NVIDIAは、NVLink 6によってラック内の72基がメモリーを共有できることも、学習や推論を支える仕組みとして挙げています。これらはNVIDIAによる性能比較で、ワークロードや構成によって結果は異なります。
SesameDiskが紹介したMLPerf Inference v6.1の結果では、Vera Rubin NVL72はQwen3-VLでGB300 NVL72を最大3.7倍、DeepSeek-R1で最大2.5倍上回ったとされています。これらは標準化された推論ベンチマークの数値で、NVIDIAが別のエージェント型処理ベンチマークで示した最大30倍という値とは測定対象が異なります。同媒体によると、前者は標準的な入力・応答の処理を測る一方、30倍の比較は長いエージェント処理を対象にしています。
資金調達案が実現した場合、報道の試算では、ラック1台を約800万ドルと仮定すると約5,000台、約36万基のRubin GPUに相当します。この試算は単価をもとにしたもので、SpaceXが構成や台数を確定したという発表ではありません。