DecisionRAGは文書の階層をたどって検索
Cornell大学などの研究チームが、検索拡張生成(RAG)で根拠文書を探す手法「DecisionRAG」を発表しました。キーワードや埋め込みの索引を使わず、意思決定モデルで文書群の階層をたどります。268万段落のWikipediaを含む評価では、検索時間は1回あたり0.68~1.76秒でした。
RAGは、生成AIが回答を作る前に外部文書から根拠を検索する仕組みです。従来の検索では、キーワードの一致や、文章の意味の近さを数値化した埋め込みとの照合が広く使われています。
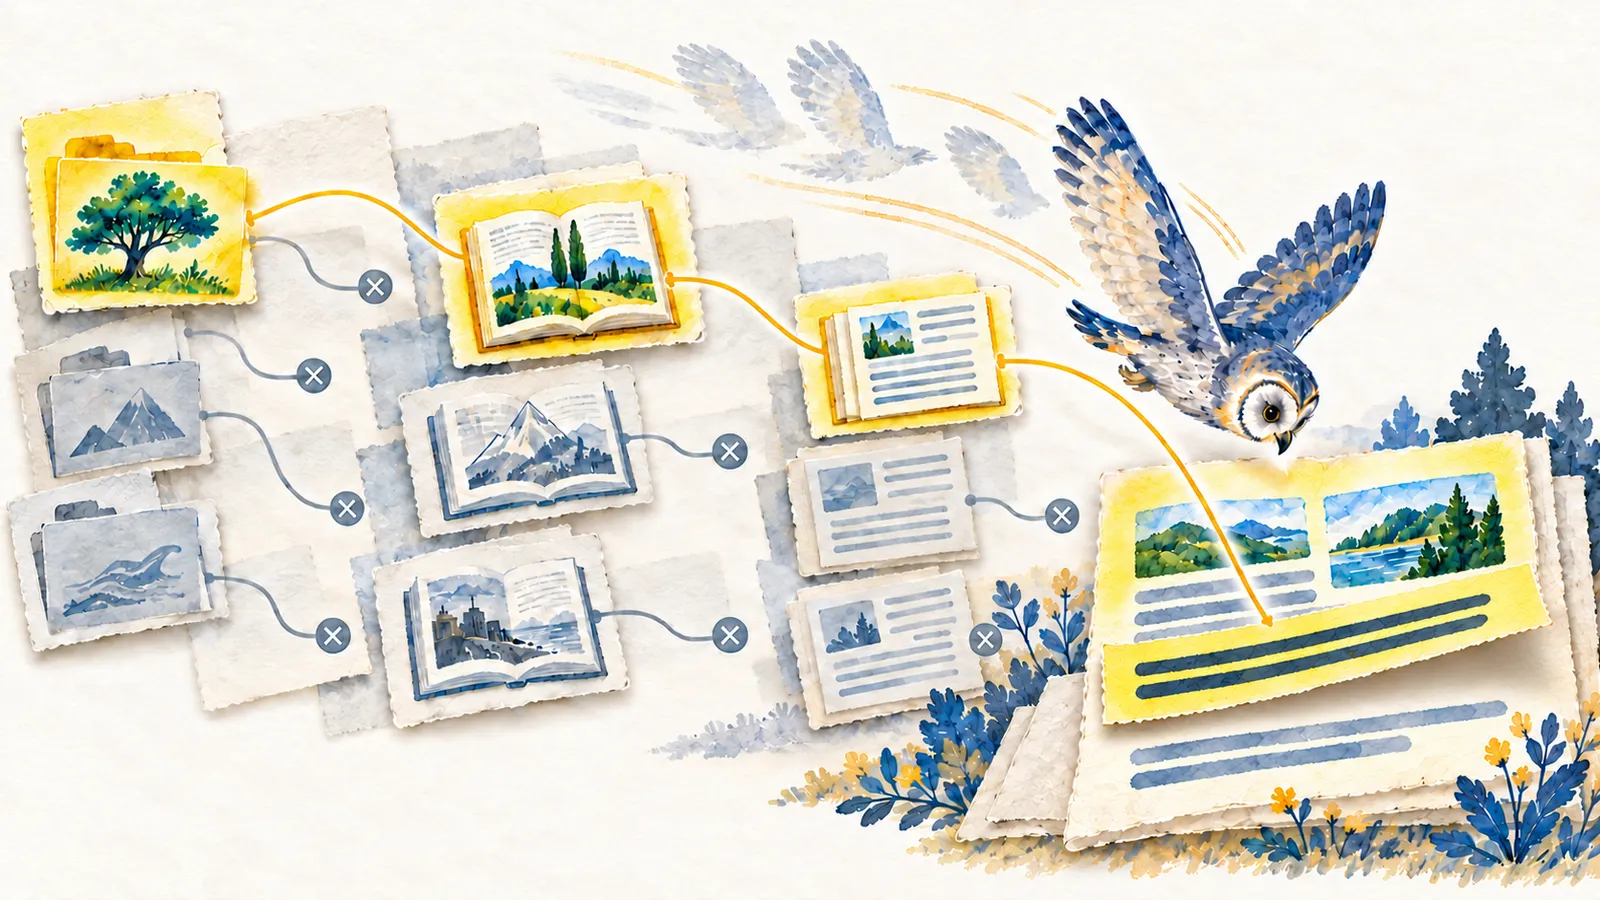
DecisionRAGは、質問に合う文書を「トピック→文書→段落」の順に絞り込みます。意思決定モデルは、文章を生成せず、選択肢への判断や確率を返すモデルです。各段階で候補を評価し、有望な枝を下の階層へたどります。
候補をまとめて評価し、枝を絞る
各階層では候補を1件ずつ別々に判定せず、共通の文脈に並べて一度に評価します。候補ごとの質問への適合度を比べ、次に調べる枝を選びます。
最初にトピックや文書タイトルなど幅広い候補を評価し、選んだ文書の下にある段落へ進みます。候補の提示と判断を階層ごとの1回の処理にまとめ、文章を生成せずに検索します。
判定で見込みが低いとされた枝は、その先を調べません。研究チームは、この枝刈りで検索対象を絞れる一方、誤って除外した枝から正解を取り戻せない可能性も説明しています。
ベンチマークでは精度と速度を評価
対話検索ベンチマーク「MultiDoc2Dial」では、正解の段落を1位に出す割合(R@1)は47.4%でした。ベクトル検索と8B規模のリランカーを組み合わせた方式の33.6%を13.8ポイント上回りました。
268万段落のWikipediaを対象にした「Natural Questions」では、1位に正解を出す割合(Hit@1)は65.4%でした。ベクトル検索の上位候補をGPT-5で並べ替える方式は60.8%で、DecisionRAGの評価値が上回りました。
検索1回の時間は0.68~1.76秒でした。GPT-5による並べ替えの11.8~15.0秒や、GPU1枚で動かしたリランカーの3.3~14.3秒より短い結果です。API費用は1回あたり0.22~2.33セントです。
併用構成とモデルの選択肢
DecisionRAG単独では、早い段階で正解を含む枝を外すリスクがあります。研究チームは、残す枝を増やす方法や、ベクトル検索で得た上位候補を最終選考に加える方法を挙げています。
ベクトル検索を併用した構成では、4種類のベンチマークすべてでDecisionRAG単独より精度が上がりました。Natural QuestionsのHit@1は65.4%から66.4%に、MultiDoc2DialのR@1は47.4%から48.5%になりました。
判定役には、追加学習をしていない意思決定モデル「Jev 1.13」が使われました。研究チームがQwen3-8Bを意思決定モデルとして訓練した評価では、MultiDoc2DialのR@1は60.7%でした。JevはTypeSafe AIがAPIで提供し、Cloudflareは意思決定モデル「Clef」の重みを公開しています。