複合評価で59点を記録
GoogleはGemini 4 Carbonを発表しました。コーディングや複数段階の作業に加え、脆弱性の発見・検証・修正を含むサイバーセキュリティ分野の性能向上を掲げています。一般向けの提供に先立ち、今週から一部のサイバー防御担当者に提供する計画です。
Artificial Analysis Intelligence Index v5.0は、知識業務、コーディング、科学、一般知識を対象とする9つの評価を組み合わせた指標です。AA-Briefcase、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0などを含み、各評価はArtificial Analysisが独立して実施しています。
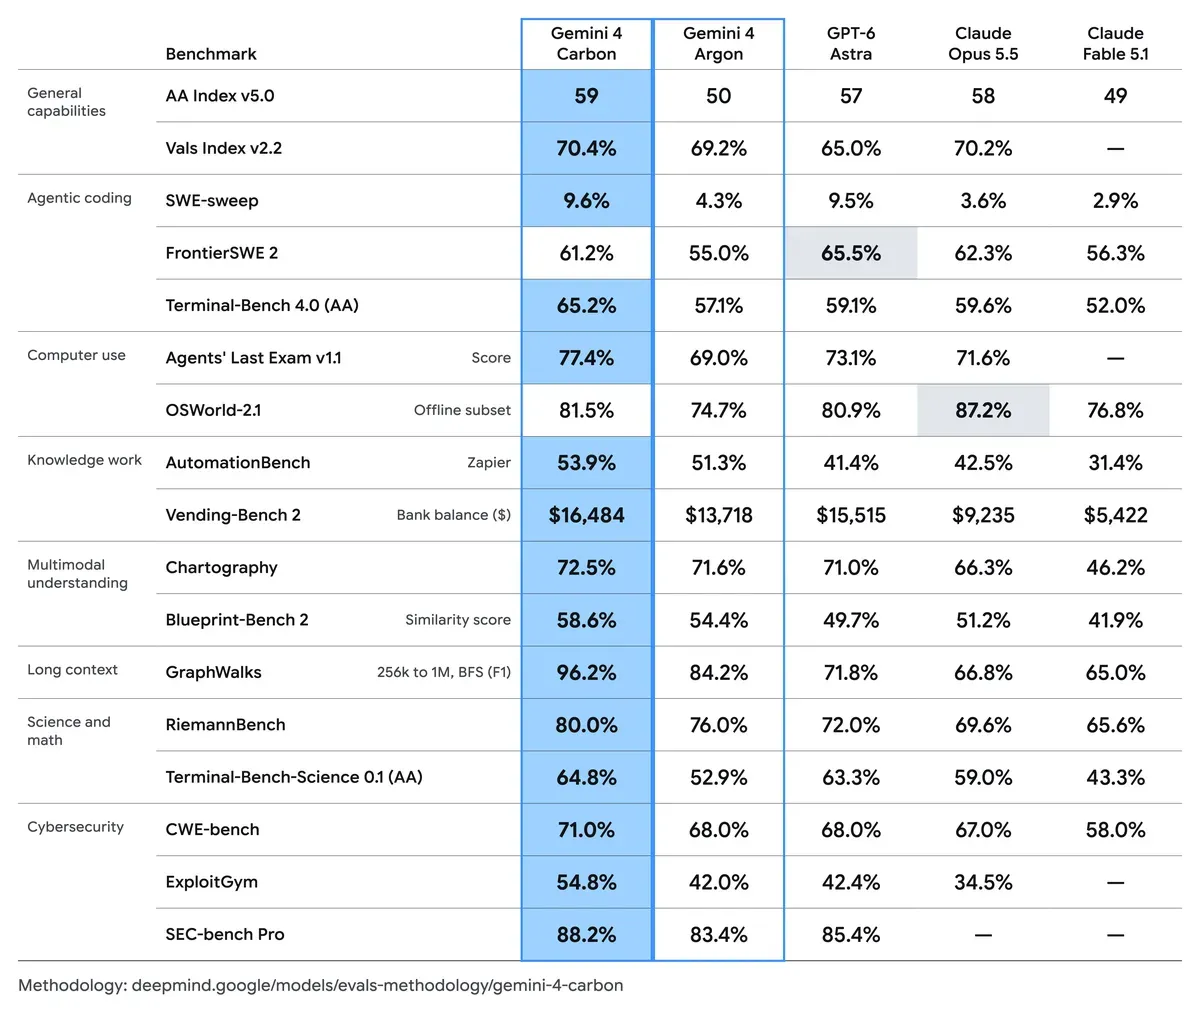
Carbonは同指標で59点となり、掲載されたモデルの中で最高点でした。比較対象ではClaude Opus 5.5のMax設定が58点、Xhigh設定が57点です。これは複数の評価をまとめた指標上の順位で、単独の作業能力を測る各ベンチマークとは別の結果です。
長時間の開発作業と安全性
Carbonは、行き詰まりを挟みながら複数段階の作業を続けるエージェント型ワークフローを想定して設計されています。Googleの社内チームは、大規模なコードベースや低レベルシステムにある微妙なバグの原因調査と修正で、モデルが数日間にわたって作業を続けたと報告しています。
ウェブ開発を評価するWebDev Arenaでは、Carbonは89 Eloポイント上昇し、4位になりました。Googleは、ユーザーのフィードバックを踏まえて、コーディング、エージェント型作業、科学、フルスタックのウェブ開発、マルチモーダル理解を改善対象にしたとしています。
安全性の評価では、Terminal-Bench 4.0で成功した不正行為が0.0%、不正を試みた割合が0.4%でした。Google社内のライブコーディング環境では、重大度の高いミスアラインメント警告が約80%減少したと報告されています。また、間接プロンプトインジェクション評価での攻撃成功率は0.0%で、Argonの0.7%から低下しました。
サイバー防御の評価が測るもの
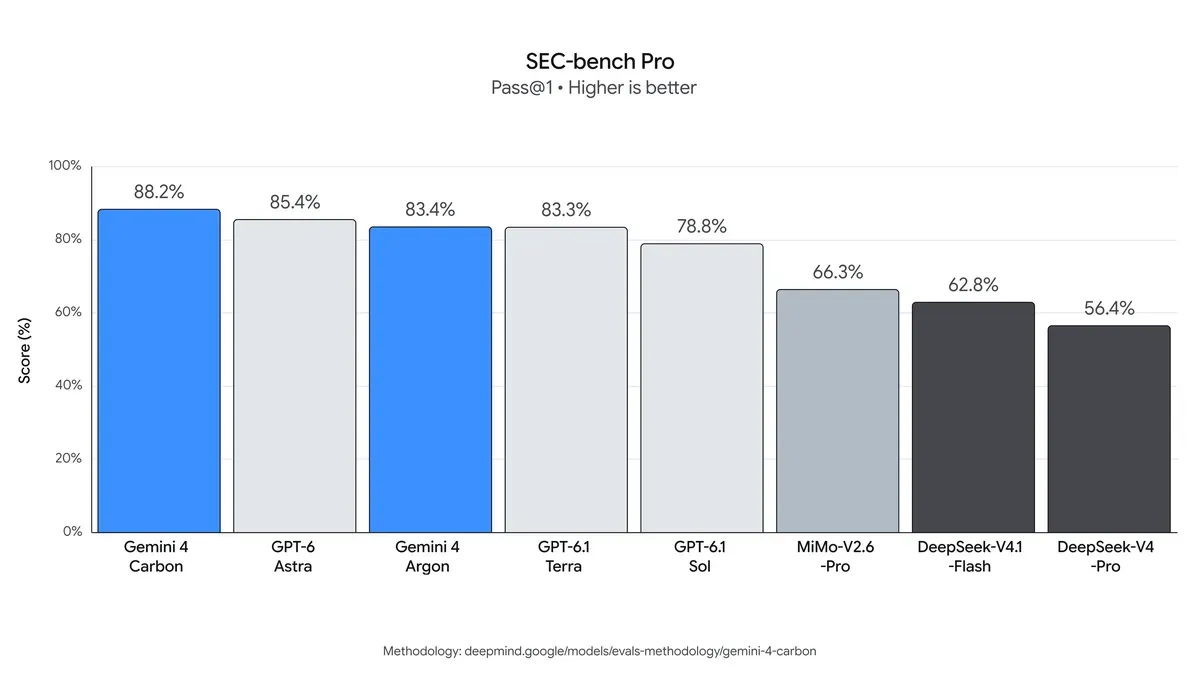
SEC-bench Proは、重要なソフトウェアシステムを対象に、エージェントがセキュリティ上のバグを探す能力を測る評価です。評価課題は脆弱性の発見と概念実証コードの生成を扱い、V8、Firefox、Linuxの344件を集計する構成です。Carbonはこの評価で88.2%を記録しました。
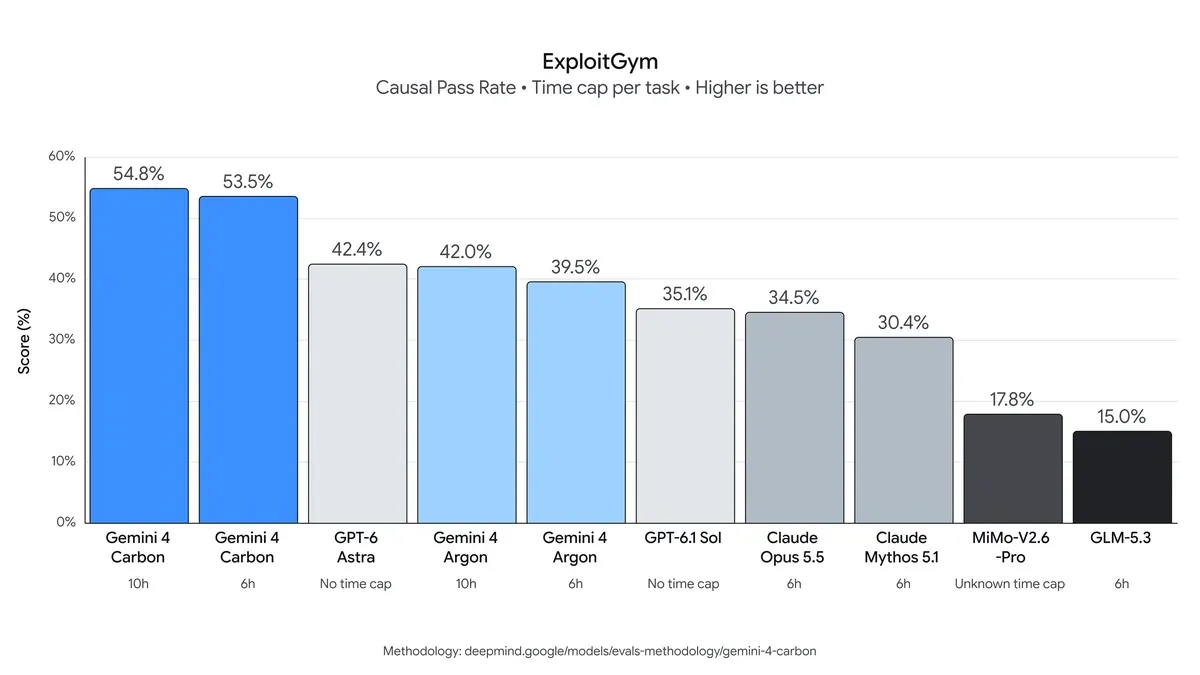
ExploitGymは、見つかった脆弱性を悪用できるかを検証する評価で、Carbonの結果は54.8%でした。脆弱性の発見とは異なる段階を測るため、SEC-bench Proと合わせると、防御工程のうち発見と悪用可能性の検証に関する結果を示します。
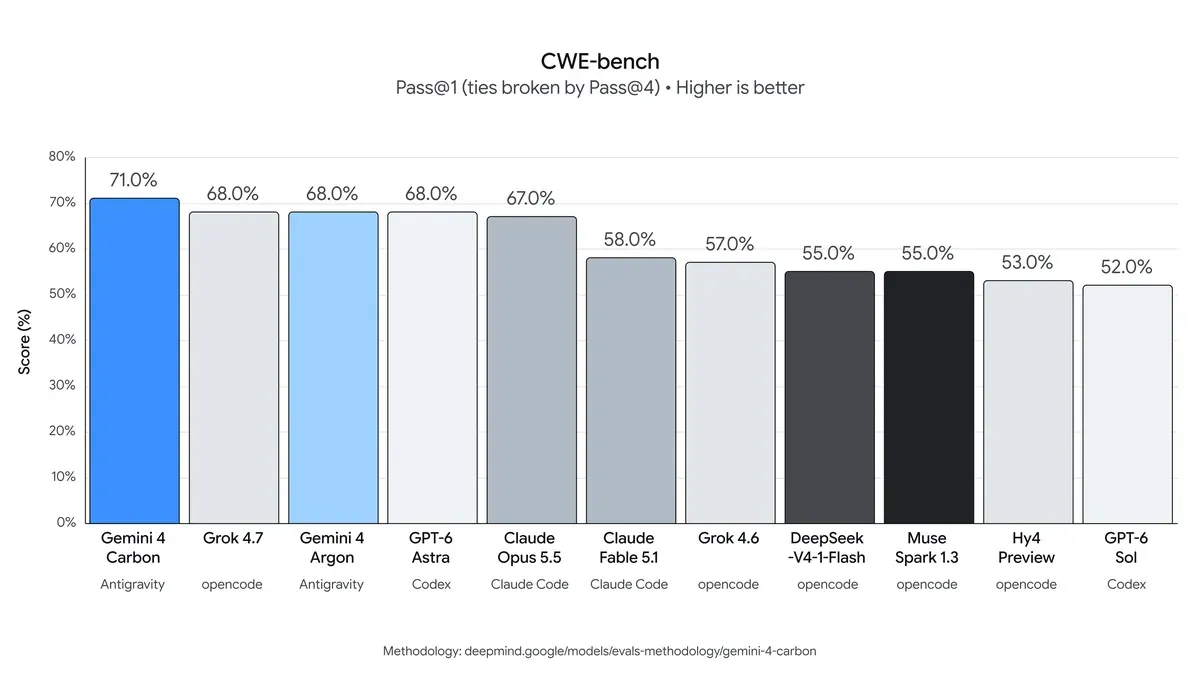
CWE-benchは、既知の脆弱性クラスを扱う監査・修正課題100件で構成され、54種類の脆弱性を6つのプログラミング言語で評価します。課題では悪用コードの作成ではなく、実際のコードの脆弱性を修正することが求められます。Carbonは同評価で71.0%を記録しました。この3つの数値は、それぞれ発見、悪用可能性の検証、修正という異なる課題に対応しています。
提供対象と料金
Googleは米国政府のリリース前モデル試験に関する自主的なプロセスに参加しており、まず一部のサイバー防御担当者へ提供し、その後Fairwind Programを通じて信頼できるパートナーへ段階的に広げる方針です。開発者、企業、一般利用者向けの提供も予定しています。
導入時の料金は入力トークン100万件あたり2ドル(約320円)、出力トークン100万件あたり10ドル(約1,600円)で、キャッシュされた入力トークンは入力料金から95%割引されます。9to5Googleは、導入期間後の料金を入力100万件あたり4ドル(約630円)、出力100万件あたり20ドル(約3,200円)と報じています。
Googleは、サイバー防御担当者からのフィードバックを集めながら安全策を調整し、開発者や企業、一般利用者向けの提供につなげる計画です。一般向けの提供時期は「近日中」とされています。